요약 — 1편에서는 청킹·하이브리드 검색·리랭킹으로, 2편에서는 Langflow로 파이프라인을 만들었습니다. 그래도 사내 용어와 문서 구조 때문에 검색이 빗나간다면 남은 레버는 검색 모델 자체를 우리 데이터에 맞추는 것입니다. 이 글은 RAG 파인튜닝의 핵심 재료인 합성 질문 + positive/hard negative 데이터셋을 연구 흐름 기준으로 서베이하고, 직접 만들 때의 순서와 함정을 정리합니다. 확인된 연구 결과와 제 추론은 구분해서 적었습니다.
왜 데이터셋을 만들어야 하나
범용 임베딩 모델은 공개 벤치마크에는 강하지만, 사내 약어·제품 코드·규정 문서처럼 도메인 특화 어휘에서는 “비슷해 보이지만 답이 아닌 문서”를 위로 올리는 일이 흔합니다. 청킹과 리랭킹을 아무리 다듬어도 후보 집합(첫 단계 검색)에 정답이 없으면 뒤 단계가 복구할 수 없습니다.
문제는 파인튜닝에 필요한 (질문, 정답 문서, 오답 문서) 데이터가 사내에는 거의 없다는 점입니다. 사람이 수천 건을 라벨링하는 것은 비현실적이라, 최근 연구는 LLM으로 이 데이터를 합성하는 방향으로 수렴했습니다.
학습 데이터의 구성 요소
| 요소 | 역할 | 얻는 방법 |
|---|---|---|
| 질문(query) | 실제 사용자가 던질 법한 질의 | 문서 청크마다 LLM이 생성 |
| Positive | 질문에 답이 들어 있는 청크 | 질문을 만든 원본 청크 |
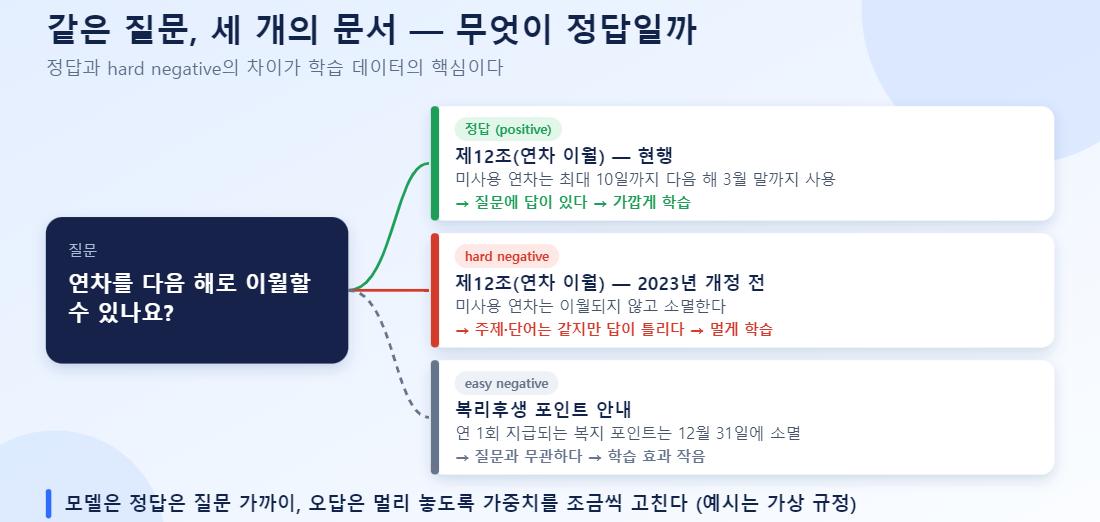
| Hard negative | 주제는 비슷하지만 답이 없는 청크 | 기존 검색기로 마이닝 또는 LLM 생성 |
| In-batch negative | 같은 배치의 다른 샘플 | 손실 함수가 자동 활용 |
Hard negative가 핵심입니다. 쉬운 오답(전혀 무관한 문서)만 보여주면 모델은 이미 구분하는 것을 반복 학습할 뿐이고, “그럴듯하게 틀린” 문서를 밀어내는 능력은 hard negative에서 나옵니다.
연구 서베이
1. 합성 질문 생성: doc2query → InPars → Promptagator
문서에서 질문을 만들어 학습 데이터로 쓰는 아이디어의 흐름입니다.
- InPars: LLM으로 코퍼스 문서에서 질문을 생성해 합성 쌍을 만들고 검색기를 학습합니다. 후속 InPars-v2는 리랭커로 생성 예시를 걸러 품질 좋은 쌍만 쓰고, 비공개 모델 대신 오픈소스 생성기를 사용했습니다.[1]
- Promptagator: 고정 템플릿 대신 데이터셋 성격에 맞춘 프롬프트에 소수의 질문-문서 예시를 넣어 질문을 생성합니다. 지도 학습 데이터 없이 작은 검색·리랭킹 모델을 학습시켰다고 보고합니다.[1]
- InPars+ (2025): 질문 생성기를 선호 최적화로 미세조정하고 DSPy로 프롬프트를 최적화해, 공격적인 필터링 의존도를 줄이면서 검색 성능을 올렸다고 보고합니다.[2]
실무 시사점: “프롬프트에 도메인 예시 몇 개를 넣는다”는 Promptagator식 접근이 가장 적은 비용으로 시작할 수 있는 출발점입니다.
2. 품질 필터링: 일관성 필터
생성된 질문 중 상당수는 모호하거나 원본 청크로 답할 수 없습니다. 연구에서 널리 쓰이는 방법은 일관성 필터링입니다. 생성한 질문으로 기존 검색기를 돌려, 원본 청크가 상위 K개 안에 들어올 때만 그 질문을 채택합니다.[1] InPars-v2처럼 리랭커 점수로 거르는 변형도 있습니다.
3. Hard negative 마이닝과 false negative 문제
Hard negative는 “상위에 올라오는데 정답이 아닌 문서”인데, 바로 그 특성 때문에 실제로는 정답인 문서가 라벨 누락으로 negative가 되는 false negative 위험이 큽니다.[3]
| 방법 | 핵심 | 비용 |
|---|---|---|
| RocketQA (denoised hard negatives) | 잘 학습된 cross-encoder로 상위 후보 중 false negative 의심 건을 제거 | 사전에 cross-encoder 필요 |
| NV-Retriever (positive-aware mining) | positive의 관련도 점수를 기준점으로 삼아 그보다 너무 가까운 후보를 제외 | 추가 모델 불필요 |
NV-Retriever는 이 마이닝 방식으로 MTEB 검색(BEIR) 평균 60.9를 기록했고, 이전 방법 대비 0.65점 높았다고 보고합니다.[4] 구체적인 임계값 공식은 논문 본문을 확인해야 합니다.
4. LLM이 직접 hard negative를 만들 수 있나
“코퍼스를 뒤지지 않고 LLM에게 hard negative 문서를 쓰게 하자”는 접근이 매력적이지만, 증거는 엇갈립니다.
- 텍스트 검색(BEIR 10개): DistilBERT를 MNRL로 학습한 비교 연구에서, LLM이 생성한 negative는 BM25나 cross-encoder로 마이닝한 negative를 일관되게 넘지 못했습니다. 평균 nDCG@10은 cross-encoder 마이닝 0.366, BM25 0.359, LLM 단독 최고 0.314(Phi4-14B)였습니다. 큰 생성 모델이 항상 더 좋은 것도 아니었습니다. 다만 단일 학생 모델·1 에폭·10k 학습 패시지라는 제한이 있고 생성물 검증도 안 했습니다.[5]
- 멀티모달 문서 리랭킹: DocReRank는 반대로 문서(페이지)당 hard negative 질문을 생성하는 방식이 마이닝 방식의 한계(다양성 부족, 낮은 난이도, false negative)를 보완해 기존 모델을 앞섰다고 보고합니다.[6]
정리하면 텍스트 RAG에서는 마이닝이 기본, LLM 생성은 보조로 보는 편이 현재 증거에 맞습니다. (이 해석은 위 두 연구를 종합한 제 판단이며, 모든 도메인에 일반화된다는 근거는 아닙니다.)
5. 도메인 RAG에 바로 적용한 사례
- ALoFTRAG: 라벨 없이 합성 데이터를 생성·필터링하고 LoRA로 미세조정하는 프레임워크로, 26개 언어 20개 데이터셋에서 인용 정확도 평균 +8.3%, 답변 정확도 평균 +3.0%를 보고합니다. 큰 교사 모델 없이 로컬에서 돌릴 수 있어 민감 데이터 도메인에 맞는다고 주장합니다.[7] 눈여겨볼 점은 검색·인용 개선폭에 비해 최종 답변 정확도 개선은 작다는 것입니다.
- 리랭커 쪽: 도메인 코퍼스만으로 LLM이 질문을 만들고 positive/hard negative를 라벨링해 cross-encoder를 증류·대조 학습하는 연구가 MedQuAD에서 도메인 내 성능을 크게 올리고 도메인 밖에도 일반화했다고 보고합니다.[8]
학습 데이터 구성 방식 3가지 — 쌍, 트리플렛, 혼합
같은 (질문, 정답) 데이터라도 오답을 어디서 가져오느냐에 따라 학습 구성이 세 갈래로 나뉩니다. 임베딩 파인튜닝에서 가장 흔한 손실인 MultipleNegativesRankingLoss(MNRL)와 InfoNCE 계열 손실을 기준으로 정리합니다.

| 방식 | 데이터 형태 | 오답(negative)의 출처 | 장점 | 주의점 |
|---|---|---|---|---|
| A. 트리플렛 | (질문, positive, negative) | 직접 지정한 hard negative + 같은 배치의 다른 샘플 | “그럴듯하게 틀린” 문서를 명시적으로 밀어냄 | negative 마이닝·검증 비용, false negative 위험 |
| B. 쌍 + 배치 내 negative | (질문, positive) | 같은 배치에 들어 있는 다른 질문들의 positive 전부 | 라벨링·마이닝 없이 바로 시작, 구현 단순 | 대부분 쉬운 오답, 배치 크기 의존, 중복 문서 오염 |
| C. 혼합 | 일부 항목만 (질문, positive, negative) | B에 더해 일부 항목에만 hard negative 추가 | 비용을 통제하면서 어려운 구간만 보강 | 데이터 형식·배치 구성을 직접 설계해야 함 |
방식 B: 쌍 + 배치 내 negative — 나머지 답을 오답으로 쓴다
질문과 정답 청크만 묶어 두고, 같은 배치에 들어온 다른 질문들의 정답 청크를 전부 오답으로 취급하는 방식입니다. DPR 계열의 표준 기법이고, sentence-transformers의 MNRL도 (anchor, positive) 쌍만 주면 같은 배치의 다른 positive를 negative로 씁니다.[9][10] 별도 마이닝 없이 배치 크기만큼 negative가 공짜로 생깁니다.
- 배치 크기가 곧 negative 수: 일반적으로 배치가 클수록 성능이 오르지만, RocketQA 실험에서는 어느 시점부터 오히려 떨어졌습니다. 배치 크기와 negative 수 사이에 균형이 필요합니다.[11]
- 대부분 쉬운 오답: 무작위로 섞인 배치의 오답은 질문과 무관한 경우가 많아, 모델이 어느 정도 학습되면 신호가 약해집니다.[9]
- 같은 문서가 한 배치에 중복되면 오염: 두 질문의 정답이 같은 청크인데 서로의 negative가 되면 정답을 오답으로 밀어냅니다. 사내 문서처럼 질문이 특정 청크에 몰리는 코퍼스에서 위험합니다. sentence-transformers의
BatchSamplers.NO_DUPLICATES가 완전히 같은 텍스트의 중복을 막아 주지만, 의미가 같은 다른 문장까지는 못 걸러냅니다.[9][12] - 대안 손실: GISTEmbedLoss는 가이드 모델로 질문과 너무 비슷한 배치 내 negative를 제외하며, 메모리가 부족할 때는 CachedMultipleNegativesRankingLoss로 유효 배치 크기를 키울 수 있습니다.[9][12]
문서 단위로 배치를 구성하거나 같은 문서에서 나온 질문을 한 배치에 몰아넣지 않는 것도 간단한 방어책입니다. 반대로 주제별로 묶어 배치를 만들면 false negative는 줄지만 배치 다양성은 줄어드는 트레이드오프가 있다고 보고됩니다.[11]
방식 A: 트리플렛 — 질문별로 오답을 직접 붙인다
각 질문에 hard negative를 한 개 이상 붙여 (질문, positive, negative)로 학습합니다. sentence-transformers 문서도 쌍보다 트리플렛을 주면 MNRL의 학습 신호를 개선할 수 있다고 안내하고, 배치 내 negative는 그대로 함께 쓰입니다.[9] 손실 구조로 보면 InfoNCE 분모에 (정답) + (배치 내 다른 positive) + (hard negative)가 모두 들어가는 형태입니다.[13]
- 효과는 “그럴듯하게 틀린” 문서를 구분하는 능력에서 나옵니다. 앞의 마이닝 단계(positive-aware 필터, 같은 문서 제외, 샘플 감사)를 반드시 거쳐야 합니다. RocketQA는 노이즈 제거 없이 hard negative를 넣으면 검색기 성능이 오히려 크게 떨어진다고 보고했습니다.[11]
- hard negative가 늘수록 질문 한 건당 처리해야 할 텍스트가 늘어 학습 시간과 메모리도 늘어납니다. 질문당 1~3개로 시작하는 편이 현실적입니다.
- 모델이 어느 정도 수렴한 뒤에는 쉬운 negative의 신호가 약해지므로, 쌍으로 먼저 학습한 다음 트리플렛을 추가하는 순서가 흔한 레시피입니다.[9]
방식 C: 혼합 — 일부 항목에만 hard negative를 단다
전 항목에 hard negative를 붙이는 대신, 쌍으로 시작해서 모델이 자주 틀리는 질문이나 혼동하기 쉬운 문서군에만 negative를 추가하는 구성입니다. 이번 조사에서 “일부 항목에만 hard negative를 다는 방식” 자체를 직접 비교·검증한 논문은 찾지 못했습니다. 아래는 위 손실 구조에서 도출한 실무 구성이며, 제 판단이 섞여 있다는 점을 밝힙니다.
- 쌍으로 1차 학습 후 평가셋에서 오답 상위에 올라온 질문(정답 순위가 낮은 질문)을 모은다.
- 그 질문들에만 마이닝한 hard negative를 붙여 트리플렛 데이터셋을 만든다.
- 나머지는 쌍 데이터셋으로 둔다.
형식 문제가 실무에서 걸림돌입니다. 한 데이터셋의 모든 행은 같은 열을 가져야 해서 일부 행의 negative 열을 비워 둘 수 없습니다. 두 가지 접근이 있습니다.
- 데이터셋 분리: 쌍 데이터셋과 트리플렛 데이터셋을 따로 만들어 딕셔너리로 넘기고 같은 MNRL로 학습합니다. 이때 한 배치는 한 데이터셋에서만 구성되므로 쌍 배치의 negative는 쌍 데이터의 positive뿐입니다. 데이터셋 비율을 맞추는 방식(
multi_dataset_batch_sampler)은 사용 중인 sentence-transformers 버전 문서에서 확인하세요. - 고정 개수로 맞추기: 항목마다 negative 개수를 고정하고, 부족한 칸은 자르거나 채우는 구현이 있습니다. 어떤 InfoNCE 구현은 샘플당 negative 개수를 고정하고 positive 점수 대비 마진으로 false negative를 마스킹하는 옵션을 제공합니다.[14] 부족한 칸을 무작위 청크로 채우면 사실상 쉬운 negative라 B와 같아집니다.
from datasets import Dataset
from sentence_transformers import SentenceTransformer, SentenceTransformerTrainer, losses

model = SentenceTransformer("BAAI/bge-m3")
train = {
    "pairs": Dataset.from_dict({"anchor": q_all, "positive": p_all}),                       # 방식 B
    "triplets": Dataset.from_dict({"anchor": q_hard, "positive": p_hard, "negative": n_hard}),  # 방식 A (일부)
}
loss = losses.MultipleNegativesRankingLoss(model)
SentenceTransformerTrainer(model=model, train_dataset=train, loss=loss).train()
위 코드는 구성 개념을 보여주는 예시이며, 열 개수가 다른 데이터셋을 한 손실로 학습하는 동작은 사용 중인 버전에서 반드시 소규모로 먼저 확인하세요.
어떤 방식을 고를까
- 평가셋도 없는 첫 시도: 방식 B(쌍 + 배치 크게 + 중복 방지)로 시작해 개선 여부부터 확인합니다.
- 비슷한 문서가 많아 오답을 자주 고르는 도메인(규정 개정판, 유사 제품 사양 등): 방식 A 또는 C로 hard negative를 보강합니다.
- 비용·시간 제약: 방식 C로 어려운 구간에만 투자합니다.
그래서 무엇이 바뀌나 — 기본 모델은 그대로, 바뀌는 것은 가중치
파인튜닝이라고 해서 모델 구조나 추론 함수를 갈아끼우는 것이 아닙니다. 기본 모델(예: BGE 계열 임베딩 모델)의 구조는 그대로 두고, 그 안의 가중치(파라미터)를 우리 데이터에 맞게 조금씩 수정합니다. 학습이 끝나면 같은 모델이 같은 방식으로 임베딩을 계산하지만, 내부 숫자가 달라져 문서와 질문이 놓이는 벡터 공간의 배치가 바뀝니다.
학습 때만 쓰이는 것과 추론 때도 남는 것
| 구분 | 무엇인가 | 학습 후 남는가 |
|---|---|---|
| 모델 구조 | 트랜스포머 층 수, 차원 등 | 그대로 (바뀌지 않음) |
| 가중치 | 모델 내부 숫자들 | 바뀐다 — 이것이 정확도 개선의 실체 |
| 손실 함수(loss) | “지금 얼마나 틀렸나”를 점수로 매기는 채점 기준 | 학습 중에만 사용, 배포 모델에는 없음 |
| 학습 데이터 구성 | 쌍·트리플렛·혼합 | 학습 중에만 사용, 가중치에 흔적으로 반영됨 |
질문하신 “함수를 바꾸는 건지”에 대한 답은, 손실 함수는 채점 기준이지 모델이 일하는 방식이 아니라는 것입니다. 모델이 문제를 풀 때 쓰는 계산은 같고, 채점 결과에 따라 가중치만 조금씩 고쳐집니다.
학습이 하는 일: 벡터 공간에서 끌어당기고 밀어내기
임베딩 모델은 질문과 문서를 숫자 벡터로 바꾸고, 가까우면 관련 있다고 판단합니다. 학습은 다음 과정을 반복합니다.
- 질문과 정답 청크의 벡터가 가까워지도록 가중치를 조정한다.
- 오답(negative) 청크의 벡터는 질문에서 멀어지도록 조정한다.
- 이 과정을 수천~수만 건 반복한다.
그래서 앞에서 본 세 가지 구성이 “무엇을 밀어낼 것인가”를 결정합니다.
| 학습 구성 | 밀어내는 대상 | 그 결과 달라지는 것 |
|---|---|---|
| B. 쌍 + 배치 내 negative | 같은 배치의 다른 질문 정답들(대체로 무관한 문서) | 도메인 용어와 문서의 기본적인 거리 관계를 익힘. 사내 약어가 어느 문서와 가까운지 학습 |
| A. 트리플렛 | 주제는 비슷하지만 답이 아닌 문서 | 비슷해 보이는 문서 사이의 미세한 구분(개정 전후 규정, 유사 제품 사양) |
| C. 혼합 | 자주 틀리는 구간만 집중해서 | 오답이 몰리는 영역의 경계를 보강 |
모델은 그대로여도 다른 것이 되는 지점들
- 전체 가중치 수정 vs 일부만 수정: 모든 가중치를 학습하는 방식(full fine-tuning)도, LoRA처럼 원본 가중치는 고정하고 작은 추가 가중치(어댑터)만 학습하는 방식도 있습니다. ALoFTRAG는 후자인 LoRA를 사용해 로컬 환경에서 적은 자원으로 돌릴 수 있다고 주장합니다.[7] LoRA는 원본 모델을 보존한 채 배포·롤백하기 쉽다는 실무적 장점이 있습니다(이 부분은 일반적인 특성 설명입니다).
- 학습 설정값(하이퍼파라미터): 배치 크기, 학습률, 에폭 수, 손실의 온도·스케일 같은 값이 변화 정도를 좌우합니다. 너무 세게 학습하면 기존에 잘하던 일반 질의 성능이 떨어지는 망각이 생길 수 있어, 일반 질의 평가셋도 함께 재측정해야 합니다.
- 손실 함수 선택: MNRL, GISTEmbedLoss, 캐시 버전 등 손실을 바꾸면 “어떤 오답을 얼마나 세게 밀어낼지”가 달라집니다. 이것이 사용자가 말씀하신 “함수를 바꾸는” 부분에 해당하며, 모델 구조는 바뀌지 않습니다.[9][12]
- 리랭커도 같은 원리: 임베딩 모델 대신 질문-문서 쌍을 읽고 점수를 내는 cross-encoder의 가중치를 같은 방식으로 고칩니다.
바뀐 뒤에 해야 하는 일
- 임베딩 모델 가중치가 바뀌면 이미 저장한 문서 벡터는 옛 모델이 만든 것이라 새 모델과 공간이 맞지 않습니다. 인덱스 전체를 재임베딩해야 합니다.
- 리랭커는 검색 결과를 다시 점수 매기기만 하므로 인덱스를 다시 만들 필요가 없습니다. 위험이 낮아 먼저 시도해 볼 만합니다. 이것은 구조상 설명이며, 어느 쪽이 효과가 큰지는 데이터마다 다릅니다.
실무 파이프라인
1단계. 코퍼스 분할과 평가셋 먼저 확보
학습 전에 문서 단위로 학습/검증을 나눕니다. 같은 문서에서 나온 청크가 양쪽에 섞이면 점수가 부풀려집니다. 평가셋에는 합성 질문뿐 아니라 실제 사용자 질문 수십 건이라도 반드시 포함합니다. 합성 질문만으로 평가하면 “합성 질문 스타일에 맞춘 모델”이 이긴 것처럼 보일 수 있습니다.

2단계. 질문 생성 — 유형을 섞는다
청크 하나에서 질문 한 가지만 만들면 분포가 좁아집니다. 사실 확인형, 절차형, 비교형, 키워드만 던지는 짧은 질의 등 유형을 지정하고, 사내 실제 질의 몇 건을 few-shot으로 넣어 말투를 맞춥니다.
PROMPT = """아래 문서 조각만 읽고 답할 수 있는 질문 {n}개를 만드세요.
- 유형을 섞으세요: 사실 확인, 절차, 비교, 두세 단어짜리 키워드 질의
- 문서 조각의 문장을 그대로 베끼지 말고 사용자가 쓸 법한 표현으로
- 문서 조각 없이도 답할 수 있는 일반 상식 질문은 금지
[실제 질의 예시]
{real_queries}
[문서 조각]
{chunk}
JSON 배열로만 출력."""
3단계. 일관성 필터
def keep(query, chunk_id, retriever, k=5):
    hits = retriever.search(query, top_k=k)
    return chunk_id in {h.id for h in hits}
필터를 통과한 비율 자체가 진단 지표입니다. 통과율이 지나치게 낮으면 질문이 모호하거나 청킹이 잘못된 것이고, 지나치게 높으면 질문이 청크 문장을 그대로 베낀 쉬운 문제일 가능성이 큽니다.
4단계. Hard negative 마이닝 (positive-aware)
기존 임베딩으로 상위 후보를 뽑되, positive보다 점수가 지나치게 높거나 비슷한 후보는 false negative 의심으로 제외합니다.
def mine_negatives(q_vec, pos_score, candidates, margin=0.95, top_n=3):
    # candidates: (chunk_id, score) 내림차순, positive 제외
    # positive 점수의 95% 이하인 것만 → false negative 가능성이 낮은 어려운 후보
    ok = [(cid, s) for cid, s in candidates if s <= pos_score * margin]
    return [cid for cid, _ in ok[:top_n]]
margin=0.95는 설명용 시작값이고 정답이 아닙니다. 이 파라미터는 코퍼스에 맞춰 조정해야 하며, 다음 두 가지도 병행하면 안전합니다.
- 같은 문서/섹션 청크 제외: 같은 규정의 인접 청크는 사실상 정답을 나눠 가진 경우가 많습니다.
- 샘플 감사: 마이닝된 negative 50건을 직접 열어 실제로 정답이 아닌지 눈으로 확인합니다.
5단계. 임베딩 파인튜닝 (bi-encoder)
anchor/positive/negative 3열 데이터에 MultipleNegativesRankingLoss(MNRL)를 쓰면 같은 배치의 다른 샘플까지 negative로 활용합니다.
from datasets import Dataset
from sentence_transformers import SentenceTransformer, SentenceTransformerTrainer, losses

model = SentenceTransformer("BAAI/bge-m3")
train = Dataset.from_dict({"anchor": queries, "positive": pos_chunks, "negative": neg_chunks})
loss = losses.MultipleNegativesRankingLoss(model)
SentenceTransformerTrainer(model=model, train_dataset=train, loss=loss).train()
- 모델명과 학습 인자는 예시이며, 사용 중인
sentence-transformers버전의 문서에서SentenceTransformerTrainer인자를 확인하세요. - 임베딩을 바꾸면 기존 벡터 인덱스를 전부 재임베딩해야 합니다.
6단계. 리랭커 파인튜닝 (cross-encoder)
리랭커는 질문-문서를 함께 읽는 모델이라 1단계 임베딩 모델로 마이닝한 hard negative를 그대로 학습 재료로 씁니다. 라벨 품질이 걱정되면 LLM에게 “이 문서가 질문에 답을 하는가”를 판정시켜 positive/negative를 한 번 더 확인하는 방식이 연구에서 쓰입니다.[8] 임베딩 파인튜닝과 리랭커 파인튜닝은 보통 한쪽만 먼저 해보고 평가셋 점수로 다음 단계를 결정하는 편이 낫습니다.
7단계. 평가 — 검색 지표와 답변 지표를 분리
| 단계 | 지표 | 보는 것 |
|---|---|---|
| 첫 검색 | Recall@k, MRR | 정답 청크가 후보에 들어오는가 |
| 리랭킹 후 | nDCG@k, Precision@k | 상위 순서가 맞는가 |
| 최종 답변 | 정답 일치율, 인용 정확도 | 사용자 체감 품질 |
ALoFTRAG 사례처럼 검색 지표가 올라도 최종 답변 개선은 작을 수 있으므로, 세 층을 따로 기록해야 어디서 효과가 났는지 보입니다.
“정확도 몇 %가 올랐다”는 무엇을 기준으로 판단하나
정확도 수치는 무엇을 맞았다고 칠지, 어떤 질문 집합으로 재는지, 무엇과 비교하는지가 정해져야 의미가 있습니다. 같은 모델도 기준이 다르면 60%도, 90%도 나옵니다.
1. 먼저 “맞았다”의 정의를 정한다
| 지표 | 정의 | 쓰임 |
|---|---|---|
| Recall@k | 질문 중 정답 청크가 상위 k개 안에 들어온 비율 | 검색 단계. “후보에 정답이 있는가” |
| MRR | 첫 정답 청크 순위의 역수(1위=1, 2위=0.5…)의 평균 | 정답이 얼마나 위에 오는가 |
| nDCG@k | 정답 여러 개와 순위를 함께 반영한 점수(0~1) | 리랭킹 후 순서의 품질 |
| 답변 정확도 | 생성된 답이 정답과 일치하는 비율. 사람 채점 또는 LLM 채점 | 최종 사용자 체감 품질 |
“RAG 정확도 90%”라는 말은 위 지표 중 무엇인지 밝히지 않으면 비교할 수 없습니다. 또한 Recall@5와 Recall@20은 같은 모델에서도 크게 다릅니다.
2. 같은 평가셋, 같은 조건으로 전·후를 비교한다
- 평가셋은 고정합니다. 학습에 쓴 문서와 겹치지 않게 문서 단위로 분리하고, 튜닝 도중에 평가셋을 보고 설정을 맞추지 않습니다.
- 기준선(baseline)은 파인튜닝 전 기본 모델입니다. “개선”은 항상 기준선 대비 차이입니다.
- 청킹·top-k·프롬프트 등 다른 조건은 동일하게 두고 모델만 바꿔 측정해야 효과가 분리됩니다.
- 가능하면 실제 사용자 질문 수십~수백 건을 포함합니다. 합성 질문만으로 측정하면 과대 평가됩니다.
3. %와 %p를 구분한다
예를 들어 평가 질문 200건에서 Recall@5가 120건(60%) → 138건(69%)이 되었다면:
- 절대 개선: +9%p (60% → 69%)
- 상대 개선: +15% (9 ÷ 60)
같은 결과를 “9% 향상”으로도 “15% 향상”으로도 말할 수 있어서, 논문이나 벤더의 “+8.3%”가 절대인지 상대인지 원문에서 확인해야 합니다. ALoFTRAG가 보고한 인용 정확도 평균 +8.3%, 답변 정확도 평균 +3.0%도 어느 쪽 정의인지는 이번 조사에서 확인하지 못했으므로 원문을 보셔야 합니다.
4. 개선이 우연이 아닌지 확인한다
평가 질문이 적으면 수치가 흔들립니다. 위 예시처럼 평가 질문 200건이면 60% 같은 수치 하나의 95% 오차 범위가 약 ±7%p입니다(이항 분포 근사 계산). 그래서 +3%p 정도의 차이는 질문을 바꾸면 사라질 수 있습니다.
- 같은 질문에 전·후 모델을 모두 돌려 질문별로 맞고 틀린 것을 비교합니다(대응 비교). 전체 수치 비교보다 오차가 작습니다.
- 부트스트랩(질문을 복원 추출해 반복 계산)이나 McNemar 검정으로 신뢰구간을 구하고, 구간이 0을 포함하면 “개선했다”고 말하지 않습니다.
- 학습 시드를 바꿔 2~3회 반복해 결과가 일관한지 봅니다.
5. 답변 정확도는 채점 방식이 곧 기준이다
- 정답 일치(Exact/포함 여부): 객관적이지만 표현이 다르면 틀린 것으로 처리합니다.
- LLM 채점: 빠르지만 채점 모델의 편향이 있어, 사람이 채점한 표본(예: 50건)과 일치율을 먼저 확인합니다.
- 인용 정확도: 답이 가리키는 출처 청크가 실제 근거인지 따로 봅니다. 이 값은 검색 개선과 더 직접 연결됩니다.
6. 보고할 때 같이 적을 것
- 지표 이름과 k 값 (예: Recall@5)
- 평가 질문 수와 구성 (합성/실제 비율)
- 기준선 수치와 개선 후 수치, 절대(%p)와 상대(%) 구분
- 신뢰구간 또는 반복 실험 결과
- 일반 질의 성능이 떨어지지 않았는지 (망각 점검)
이 기준 없이 “정확도가 N% 올랐다”고만 말하면 재현할 수 없는 수치가 됩니다.
파인튜닝 전에 확인할 것
파인튜닝은 가장 마지막 레버입니다. 아래가 먼저입니다.
- 정답이 후보에 아예 없는 건지(검색 문제), 있는데 답을 못 만드는 건지(생성 문제) 로그로 구분했는가
- 청킹 크기·오버랩, 하이브리드 검색(BM25+dense), 리랭커 도입을 이미 적용했는가 (1편)
- 사내 용어 사전·쿼리 확장처럼 데이터 없이 되는 개선을 시도했는가
자주 하는 실수
- 합성 질문만으로 평가: 학습·평가 분포가 같아져 개선이 과대 측정됩니다. 실제 질의를 반드시 섞으세요.
- false negative 방치: 어려운 negative일수록 정답일 확률이 높습니다. 같은 문서 제외와 샘플 감사를 건너뛰지 마세요.
- 필터링 없이 전량 학습: 모호한 질문이 노이즈가 됩니다. 일관성 필터는 비용 대비 효과가 큰 단계입니다.
- LLM 생성 negative에 과의존: 텍스트 검색 비교 연구에서는 마이닝을 넘지 못했습니다. 보조 수단으로 두세요.
- 재임베딩 비용 누락: 임베딩 모델 교체는 인덱스 전체 재구축을 뜻합니다.
- 기밀 문서를 외부 API로 생성: 질문 생성에 외부 LLM을 쓴다면 문서 반출 정책을 먼저 확인하고, 민감하면 로컬 모델을 쓰세요.
정리
- 합성 질문 + positive/hard negative는 사내 라벨 없이 검색 모델을 도메인에 맞추는 현실적인 방법입니다.
- 생성 → 일관성 필터 → positive-aware 마이닝 순서가 연구에서 반복 확인되는 골격입니다.
- Hard negative는 마이닝이 기본이고, false negative 관리가 품질을 좌우합니다.
- 보고된 개선폭은 연구마다 다르고, 검색 지표 개선이 최종 답변 개선으로 그대로 이어지지는 않을 수 있으므로 자체 평가셋으로 검증해야 합니다.
참고자료
- InPars Toolkit: A Unified and Reproducible Synthetic Data Generation Pipeline for Neural Information Retrieval / InPars-v2
- InPars+: Supercharging Synthetic Data Generation for Information Retrieval Systems
- Dense Text Retrieval based on Pretrained Language Models: A Survey
- NV-Retriever: Improving text embedding models with effective hard-negative mining / RocketQA
- Don’t Retrieve, Generate: Prompting LLMs for Synthetic Training Data in Dense Retrieval
- DocReRank: Single-Page Hard Negative Query Generation for Training Multi-Modal RAG Rerankers
- ALoFTRAG: Automatic Local Fine Tuning for Retrieval Augmented Generation
- Enhancing Transformer-Based Rerankers with Synthetic Data and LLM-Based Supervision
- Sentence Transformers — Natural Language Inference (triplet loss guide)
- In-Batch Negatives — ZeroEntropy (보조 자료)
- RocketQA — 배치 크기와 false negative 관련 실험
- Sentence Transformers — Batch Sampler 문서
- KaLM-Embedding-V2 — in-batch 및 hard negative를 함께 쓰는 InfoNCE 분모 구성
- Twinkle — InfoNCE Loss (false negative 마스킹 옵션)