요약 — 셋은 “성능이 좋은 순서”가 아니라 서로 다른 종류의 실패를 고치는 도구입니다. 모델이 모르는 것(지식)인지, 못 따르는 것(지시)인지, 몸에 배지 않은 것(행동·형식)인지를 먼저 진단하면 선택은 거의 자동으로 정해집니다. 이 글은 가상의 팀이 사내 AI 도우미를 만들며 겪는 세 번의 막힘을 따라가며, 각 단계에서 무엇을 보고 무엇을 선택했는지 정리합니다. (사례는 일반화한 가상 시나리오입니다.)
0. 먼저 결론: 한 장 요약
| 실패 증상 | 진짜 원인 | 첫 번째 선택 |
|---|---|---|
| 답이 장황하거나 형식이 매번 다르다 | 지시가 모호함 | 프롬프트 |
| 최신 규정·사내 문서 내용을 모른다 / 지어낸다 | 모델이 그 지식을 갖고 있지 않음 | RAG |
| 문서를 줬는데도 엉뚱한 문서가 검색된다 | 검색 품질 문제 | RAG 개선(청킹·하이브리드·리랭킹), 그래도 안 되면 임베딩 파인튜닝 |
| 말투·형식·판단 기준이 프롬프트로 안 잡힌다 | 행동이 모델에 배어 있지 않음 | 파인튜닝(SFT) |
| 특정 전문 영역 용어·문체를 근본적으로 못 쓴다 | 도메인 지식·표현 부족 | 추가 사전학습 또는 파인튜닝(드물다) |
기본 순서는 프롬프트 → RAG → 파인튜닝입니다. 비용·시간·되돌리기 쉬움이 이 순서로 커지기 때문입니다. 아래 이야기는 이 순서가 왜 합리적인지 보여줍니다.
1. 이야기의 시작 — “사내 규정을 물어보면 답해주는 도우미”
가상의 팀이 임직원이 사내 규정·업무 절차를 물으면 답해주는 AI 도우미를 만들려고 합니다. 목표는 세 가지입니다.
- 규정에 근거한 정확한 답
- 답변마다 일관된 형식(결론 → 근거 → 담당 부서)
- 규정이 바뀌면 빠르게 반영
가장 먼저 해야 할 일은 모델을 고르거나 데이터를 모으는 것이 아니라, “무엇이 틀렸는가”를 기록할 평가 질문 30~50개를 만드는 것입니다. 이후 모든 선택은 이 질문 세트의 실패 유형으로 판단합니다. 평가 세트가 없으면 세 방법 중 무엇이 효과가 있었는지조차 알 수 없습니다.
2. 1막 — 프롬프트로 어디까지 가능한가
팀은 가장 싼 방법부터 시작합니다. 시스템 프롬프트에 역할, 답변 형식, 모르면 모른다고 답하라는 규칙, 예시 2~3개(few-shot)를 넣습니다.
프롬프트가 해결한 것 – 형식이 들쭉날쭉하던 문제 (결론 → 근거 → 담당 부서 고정) – 장황한 답변, 존댓말·어조 통일 – 근거 없이 단정하는 습관 (불확실하면 확인 필요라고 쓰게 함)
프롬프트로 해결되지 않은 것 – “휴가 이월 규정이 어떻게 되죠?” → 그럴듯하지만 틀린 숫자를 답함
여기서 핵심 구분이 나옵니다. 형식·태도 문제는 프롬프트로 풀리지만, 모델이 애초에 모르는 사실은 프롬프트로 만들어낼 수 없습니다. 지시를 아무리 정교하게 써도 사내 규정은 모델 안에 없기 때문입니다.
판단 기준 ①: 정답 정보를 프롬프트에 직접 붙여 넣으면 맞게 답하는가? – 맞게 답한다 → 모델 능력은 충분하고 정보를 넣어주는 방법이 필요하다 → RAG – 그래도 틀린다 → 지시·추론·형식 문제 → 프롬프트 개선 또는 파인튜닝
이 “붙여 넣어 보기” 실험은 5분이면 되고, RAG로 갈지 말지를 거의 확정해 줍니다.
3. 2막 — RAG: 모르는 것은 찾아서 보여준다
붙여 넣으면 맞게 답했으므로 팀은 RAG로 갑니다. 규정 문서를 쪼개 인덱싱하고, 질문이 오면 관련 조각을 찾아 프롬프트에 함께 넣습니다. (구축 방법은 RAG 파이프라인: 청킹·하이브리드 검색·리랭킹과 Langflow로 만드는 RAG 참고)
RAG가 해결한 것 – 사내 규정 내용에 근거한 답변 – 규정 개정 시 문서만 갱신하면 반영 (재학습 불필요) – 출처 표기 가능 → 검증·감사 용이 – 권한별 문서 접근 제어 (문서 단위로 통제 가능)
RAG를 선택하는 신호 – 답이 자주 바뀌거나 비공개인 지식에 있다 – 답변에 출처가 필요하다 – 지식의 양이 프롬프트에 다 넣기엔 크다
그런데 새로운 실패가 생긴다. 평가 질문을 돌려 보니 실패가 둘로 갈렸습니다.
| 실패 유형 | 확인 방법 | 의미 |
|---|---|---|
| 정답 문서가 검색 결과에 없다 | 검색된 조각을 직접 확인 | 검색 문제 |
| 정답 문서가 검색됐는데 답이 틀리다 | 검색 결과에 정답이 있음 | 생성(프롬프트·모델) 문제 |
판단 기준 ②: RAG가 틀릴 때는 검색 단계와 생성 단계를 분리해서 본다. 많은 팀이 이 분리를 하지 않고 “RAG는 정확도가 낮다”고 결론 내립니다.
- 검색이 문제 → 청킹 크기·겹침 조정, 키워드+벡터 하이브리드 검색, 리랭킹 순으로 개선합니다. 파인튜닝은 이 단계들을 다 해 본 뒤의 선택지입니다.
- 생성이 문제 → 컨텍스트를 어떻게 제시하고 어떻게 답하게 할지, 즉 다시 프롬프트 문제입니다.
4. 3막 — 파인튜닝은 정말 필요한가
개선을 거듭해도 두 가지 문제가 남았다고 가정해 봅시다.
(가) 사내 용어 검색 실패: 사내에서만 쓰는 약어·별칭 때문에 일반 임베딩이 관련 문서를 놓친다. → 이 경우의 파인튜닝은 답변 모델이 아니라 검색 모델(임베딩·리랭커) 대상입니다. 합성 질문과 hard negative로 데이터셋을 만드는 방법은 RAG 파인튜닝: 합성 질문·Hard Negative에서 다뤘습니다.
(나) 행동·판단 방식 문제: 프롬프트에 규칙을 20개 넣어도 답변 형식과 거절 기준이 흔들린다. 프롬프트가 길어져 비용·지연도 커진다. → 이 경우가 SFT(지도 파인튜닝) 의 영역입니다. 지식을 주입하는 것이 아니라 행동을 몸에 배게 하는 용도입니다.
파인튜닝을 선택하는 신호 – 프롬프트와 RAG를 충분히 개선했는데도 같은 유형의 실패가 반복된다 – 원하는 입출력 예시를 수백~수천 건 만들 수 있다 (품질 좋은 정답이 있다) – 요구가 스타일·형식·분류 기준·도구 호출 방식 같은 행동이다 – 호출량이 많아 긴 프롬프트 비용·지연을 줄이는 것이 가치가 있다 – 작은 모델로 같은 품질을 내고 싶다 (증류)
파인튜닝을 하지 말아야 하는 신호 – 목적이 “최신 지식·사내 문서를 외우게 하기” → 지식 주입은 RAG가 낫다. 파인튜닝은 지식을 불안정하게 넣고, 갱신하려면 재학습이 필요하며, 출처도 댈 수 없다. – 평가 세트가 없다 → 좋아졌는지 알 수 없다 – 데이터가 적거나 품질이 낮다 → 오히려 성능이 나빠질 수 있다 (기존 능력을 잊는 망각 위험) – 규정이 자주 바뀐다 → 바뀔 때마다 재학습
판단 기준 ③: 부족한 것이 “사실” 이면 RAG, “행동” 이면 파인튜닝. 사실은 바뀌지만 행동은 비교적 안정적이라서, 바뀌는 것은 밖(RAG)에 두고 안 바뀌는 것만 안(모델)에 넣습니다.
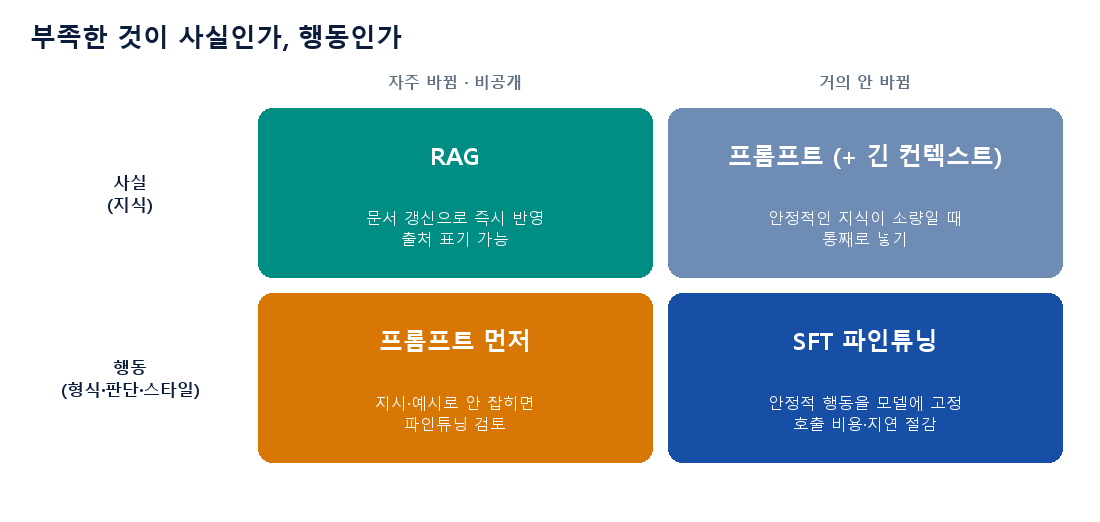
5. 운영 관점에서 다시 보기 — 비용·지연·유지보수
선택은 정확도만으로 정해지지 않습니다. 같은 정확도라면 싸고, 빠르고, 고치기 쉬운 쪽이 이깁니다.
프롬프트 – 비용은 호출마다 입력 토큰으로 발생합니다. 규칙과 예시가 길어질수록 모든 호출에 반복 비용이 붙습니다. – 수정이 즉시 반영되고 되돌리기 쉽습니다. 대신 규칙이 늘면 서로 충돌하고, 어느 규칙이 효과를 냈는지 추적하기 어려워집니다.
RAG – 호출마다 검색 지연과 컨텍스트 토큰이 추가됩니다. 검색 인프라(인덱스, 임베딩 갱신, 문서 수집 파이프라인)를 운영해야 합니다. – 비용의 대부분은 모델이 아니라 데이터 품질 관리입니다. 오래된 문서, 중복 문서, 권한이 다른 문서가 섞이면 답이 흔들립니다. 문서 담당자와 갱신 주기를 정해 두지 않으면 RAG는 시간이 갈수록 나빠집니다.
파인튜닝 – 학습 비용보다 데이터 만드는 비용이 큽니다. 좋은 정답 예시를 사람이 검수하며 만들어야 합니다. – 모델 버전이 바뀌면(기반 모델 업그레이드) 다시 학습하고 다시 평가해야 합니다. 한 번 하고 끝나는 작업이 아니라 유지보수 대상이 생기는 결정입니다. – 대신 호출당 비용은 줄어들 수 있습니다. 긴 프롬프트를 모델에 내재화하면 입력 토큰이 줄고, 더 작은 모델로 같은 작업을 시킬 수도 있습니다. 호출량이 매우 많은 서비스에서 투자 가치가 생기는 이유입니다.
판단 기준: 파인튜닝은 “정확도가 더 필요해서”보다 “반복되는 행동을 싸고 안정적으로 만들어야 해서” 선택하는 경우가 더 많습니다.
6. 사례로 연습하기 — 증상에서 선택까지
같은 질문을 직접 판정해 보세요. 각 사례는 위의 기준 ①~③을 그대로 적용한 것입니다.
| 사례 | 관찰된 증상 | 진단 | 선택 |
|---|---|---|---|
| 고객 문의 답변 초안 | 내용은 맞는데 어조·길이가 담당자마다 다르게 나온다 | 지식은 충분, 지시가 모호 | 프롬프트(어조 가이드 + 예시 3개) |
| 제품 매뉴얼 챗봇 | 신제품 기능을 물으면 모른다고 하거나 옛 기능을 설명한다 | 최신·비공개 지식 부재 | RAG(매뉴얼 인덱싱, 개정 시 갱신) |
| 같은 RAG인데 약어 질문만 실패 | 사내 약어로 물으면 정답 문서가 검색되지 않는다 | 검색 모델이 약어를 모름 | 먼저 동의어·질의 확장·하이브리드 검색, 안 되면 임베딩 파인튜닝 |
| 계약서 위험 조항 분류 | 프롬프트 규칙 25개를 넣어도 분류 기준이 흔들리고 호출 비용이 크다 | 행동(판단 기준)이 안 배어 있음 | SFT 파인튜닝(검수된 분류 예시 수백 건) |
| 법령 해설 서비스 | 법령이 매달 개정되고 근거 조문 표기가 필수다 | 지식이 자주 바뀌고 출처 필요 | RAG (파인튜닝은 부적합) |
사례를 풀 때의 요령은 “무엇이 틀렸는지”를 한 문장으로 먼저 쓰는 것입니다. “정확도가 낮다”가 아니라 “개정된 조항을 모른다”, “형식이 흔들린다”, “정답 문서가 안 나온다”처럼 쓰면 도구가 저절로 정해집니다.
7. 현실의 정답은 조합이다
실제 서비스는 하나만 쓰지 않습니다. 흔한 조합은 다음과 같습니다.
- 프롬프트만 — 지식이 필요 없는 변환·요약·분류. 가장 먼저 시도.
- 프롬프트 + RAG — 사내 지식 질의응답의 기본형. 대다수 서비스가 여기서 충분합니다.
- 프롬프트 + RAG + 검색 모델 파인튜닝 — 전문 용어가 많아 검색이 계속 빗나가는 도메인.
- 프롬프트 + RAG + SFT — 지식은 RAG로, 답변 방식·판단 기준은 파인튜닝으로 고정. 호출량이 크고 품질 요구가 높은 서비스.
- 에이전트 + 여러 소스 — 문서뿐 아니라 DB·API까지 필요한 경우. 이 구조는 다음 글에서 다룹니다.
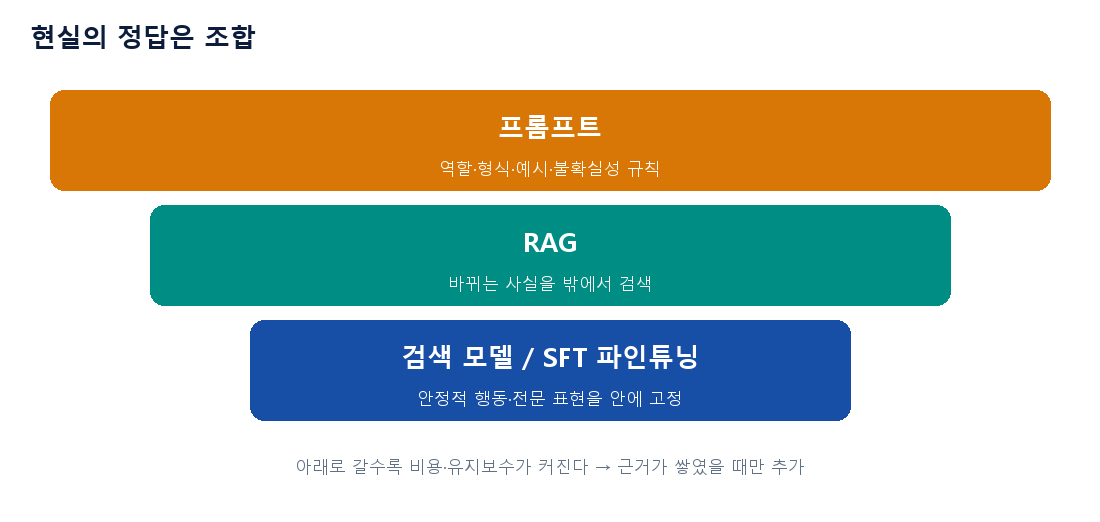
조합할 때의 원칙은 바뀌는 것은 밖에, 안 바뀌는 것은 안에 두는 것입니다. 규정·가격·제품 정보처럼 바뀌는 사실은 RAG(밖)에 두고, 답변 형식·판단 기준·전문 용어 사용법처럼 안정적인 행동은 프롬프트나 모델(안)에 둡니다.
8. 의사결정 흐름 (질문 순서)
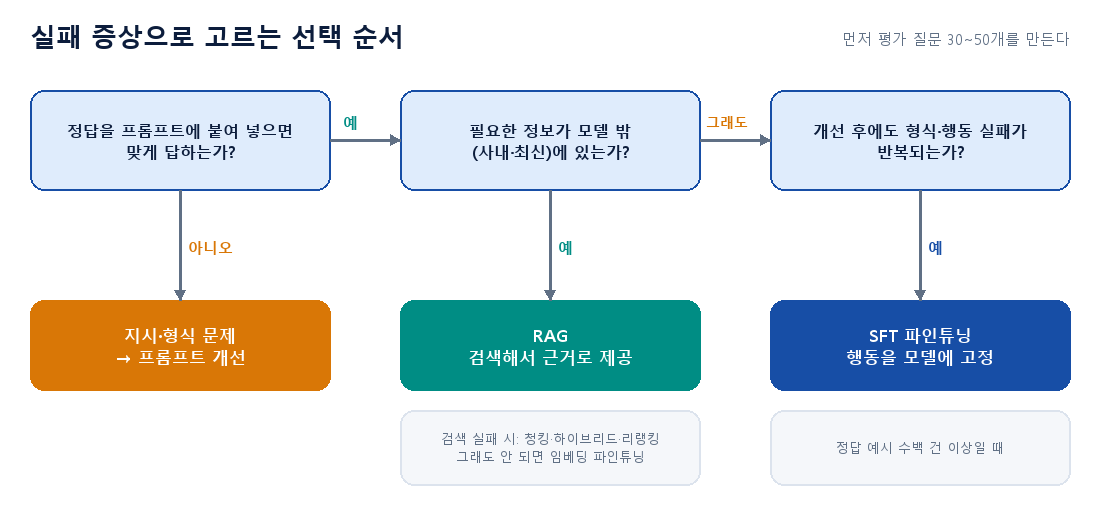
- 평가 질문 세트가 있는가? 없다면 먼저 만든다. (30~50개면 시작 가능)
- 정답 정보를 프롬프트에 붙여 넣으면 맞게 답하는가?
- 아니오 → 프롬프트 구조·모델 선택부터 재점검. 그래도 안 되면 파인튜닝 검토
- 예 → 3번
- 필요한 정보가 모델 밖(사내·최신·비공개)에 있는가? → 예: RAG (문서·이미지 등 비정형 데이터. DB의 숫자·집계는 사내 DB 데이터를 LLM에 서빙하는 방법에서 다룹니다)
- RAG 실패를 검색/생성으로 분리했는가?
- 검색 문제 → 청킹·하이브리드·리랭킹 → 안 되면 임베딩·리랭커 파인튜닝
- 생성 문제 → 프롬프트 개선
- 프롬프트·RAG를 개선했는데도 형식·행동·판단 기준 실패가 반복되는가? + 고품질 예시 수백 건 이상? → SFT 파인튜닝
- 조합이 현실적 정답이다. 대부분의 서비스는 프롬프트 + RAG, 일부가 여기에 검색 모델 또는 SFT 파인튜닝을 더합니다.
9. 비교 한눈에 보기
| 항목 | 프롬프트 | RAG | 파인튜닝 |
|---|---|---|---|
| 해결하는 것 | 지시·형식·태도 | 외부·최신·비공개 지식 | 행동·스타일·도메인 표현 |
| 시작 비용 | 매우 낮음 | 중간 (인덱싱·검색 인프라) | 높음 (데이터·학습·평가) |
| 반영 속도 | 즉시 | 문서 갱신 시 즉시 | 재학습 필요 |
| 출처 표기 | 불가 | 가능 | 불가 |
| 지식 갱신 | 불가 | 쉬움 | 어려움 |
| 주된 위험 | 지시 충돌, 프롬프트 비대 | 검색 실패, 오래된 문서 | 데이터 품질, 망각, 유지보수 |
| 되돌리기 | 쉬움 | 쉬움 | 어려움 |
10. 흔한 오해 세 가지
- “파인튜닝하면 우리 문서를 다 외운다” — 지식 주입 수단으로는 비효율적이고 부정확합니다. 문서 지식은 RAG가 기본입니다.
- “RAG를 쓰면 환각이 없다” — 검색이 틀리거나 모델이 컨텍스트를 무시하면 여전히 틀립니다. 답이 문서에 근거하는지 평가해야 합니다.
- “긴 컨텍스트 모델이 나오면 RAG는 필요 없다” — 문서가 적고 안정적이면 통째로 넣는 것이 가장 단순한 선택일 수 있습니다(붙여 넣기 실험의 연장). 하지만 문서량, 비용, 지연, 권한 통제, 출처 요구가 커지면 다시 RAG가 필요해집니다.
11. 시작 전 체크리스트
- [ ] 평가 질문 30~50개와 정답 기준이 있다
- [ ] 정답 정보를 직접 붙여 넣는 실험을 해 봤다
- [ ] 실패를 “지식 / 검색 / 지시 / 행동”으로 분류했다
- [ ] 프롬프트(역할·형식·예시·불확실성 규칙)를 먼저 정리했다
- [ ] RAG 실패를 검색·생성으로 분리해서 측정한다
- [ ] 파인튜닝 전에 데이터 품질·양, 평가 방법, 재학습 계획을 정했다
- [ ] 개선 효과를 같은 평가 세트로 전후 비교한다
12. 정리
- 선택의 출발점은 방법이 아니라 실패 증상의 진단입니다.
- 부족한 것이 사실이면 RAG, 행동이면 파인튜닝, 지시면 프롬프트입니다.
- 순서는 싸고 되돌리기 쉬운 것부터: 프롬프트 → RAG → (검색 모델 / SFT) 파인튜닝.
- 파인튜닝은 최후의 수단이 아니라 근거가 쌓였을 때 선택하는 도구입니다. 근거는 평가 세트가 만들어 줍니다.
다음 편: 사내 DB 데이터를 LLM에 서빙하는 방법 — 문서가 아니라 숫자·집계 질문일 때. 그 다음 편: 평가 세트 만드는 법 — 질문 선정, 정답 기준, 검색/생성 분리 측정 방법
이 글의 판단 기준은 공개된 일반적인 실무 지침과 저자의 정리에 기반한 것이며, 모델·도구·비용 구조는 빠르게 바뀌므로 도입 전 최신 공식 문서와 직접 실험으로 확인하세요.