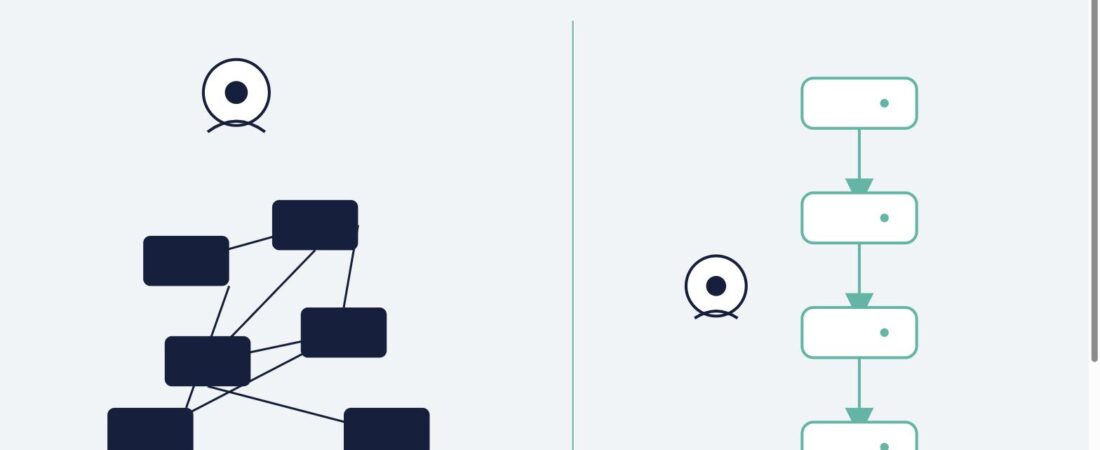
ERP 테이블을 Ontology(온톨로지)의 Object Type으로 옮기고, 컬럼에 비즈니스 설명을 붙이고, FK를 Link Type으로 등록해두면 — 사용자가 아무 자연어 질문이나 던져도 AIP가 “정의된 범위 안에서만” 쿼리를 만들어낸다.
이 글은 그 메커니즘을 팔란티어 공식 문서와 독립 기술분석을 근거로 정리한다. 핵심은 세 가지다.
- AI는 등록된 Link Type만 탈 수 있다(관계 추론 제약)
- description은 LLM에게 “함수 파라미터 설명”으로 제공된다
- LLM은 쿼리를 즉석에서 짜는 게 아니라, 미리 있는 함수를 골라 호출할 뿐이다
온톨로지 구조 기초 — RDB와 무엇이 같고 다른가
RDB와 유사해 보이는 직관은 맞다. 다만 결정적인 차이 하나가 전체 메커니즘을 좌우한다.
| RDB 개념 | Ontology 대응 개념 | 차이점 |
|---|---|---|
| 테이블 | Object Type | 동일한 개념. 다만 각 필드에 비즈니스 설명이 필수로 붙는다. |
| 컬럼 | Property | 컬럼명(cust_addr_1) 대신 표시이름(“배송지 주소”) + description이 별도로 존재. |
| 외래키(FK) | Link Type | 가장 중요한 차이. FK는 JOIN 시점에 즉석으로 해석되지만, Link Type은 스키마에 미리 등록된 독립 객체다. 이름과 방향(양방향 각각 다른 표시이름)까지 갖는다. |
| 즉석 JOIN(SQL) | 정의된 Link 순회(traversal) | SQL은 실행 시점에 임의의 테이블 조합으로 JOIN을 짤 수 있지만, 온톨로지는 사전 등록된 Link만 순회 가능하다. |
팔란티어 공식 문서는 온톨로지를 두 겹으로 설명한다 — 명사(Object·Link·Property)로 이루어진 시맨틱 계층(Language layer)과, 동사(Action·Function)로 이루어진 실행 계층(Kinetic layer). 그리고 이렇게 못 박는다.
“The Ontology is not a ‘semantic layer’; the fourfold integration and operationalization of data, logic, action, and security cannot be accomplished with a thin semantic layer.”
— Palantir, The Ontology system
AIP가 온톨로지로 LLM을 그라운딩하는 방식
Object Query Tool — 접근 범위를 사람이 먼저 정한다
AIP Agent Studio 공식 문서는 이렇게 설명한다.
“이 LLM이 접근할 수 있는 Object Type을 지정한다. 여러 Object Type을 추가할 수 있고, (토큰 효율을 위해) 접근 가능한 프로퍼티를 구체적으로 지정할 수 있다.”
— AIP Agent Studio · Tools Overview
필터링·집계·조회뿐 아니라 이미 구성된 링크에 한해 탐색도 지원한다. 도구 호출 방식은 두 가지다 — 어떤 모델에서도 동작하지만 한 번에 하나씩만 호출하는 Prompted 모드, 병렬 호출이 가능하지만 지원 모델이 제한된 Native 모드.
AIP Logic — description이 실제로 LLM 컨텍스트에 들어가는 지점
“Object type descriptions and properties become available to the LLM.”
— AIP Logic · Overview
Use LLM 블록에 온톨로지 객체를 연결하면, description을 포함한 스키마가 모델 컨텍스트에 실제로 노출된다. 보안은 같은 문서에 명시되어 있다 — 행·열 단위 접근 제어가 모델이 사용자를 대신해 읽을 수 있는 데이터를 필터링하며, 모델은 사용자가 권한 없는 데이터를 절대 볼 수 없다.
핵심 보안 원칙 — LLM은 도구를 “요청”할 뿐, “실행”하지 못한다
“LLMs do not have direct access to tools; LLMs can only ask to use tools, and these tool calls are then executed by AIP Logic within the invoking user’s permissions.”
— AIP Logic · Core concepts
이 한 문장이 구조의 핵심을 뒷받침한다. LLM은 “이 도구를 이 파라미터로 써줘”라는 텍스트 요청만 생성하고, 실제 그래프 탐색·데이터 조회는 플랫폼의 결정론적 엔진이 권한 검증 후 수행한다.
여기서 반드시 짚어야 할 점 — 이 제약은 “하지 말라”는 프롬프트 지시(soft constraint)가 아니라, 물리적으로 실행 경로 자체가 없는 구조적 제약(hard constraint)이다.
| 프롬프트 지시(가정) | 실제 구조 | |
|---|---|---|
| 강제 방식 | 시스템 프롬프트에 “이건 하지 마” 문구 | 요청을 실행하는 함수/도구 자체가 존재하지 않음 |
| 우회 가능성 | 이론적으로 탈옥(jailbreak) 가능 | LLM의 출력과 무관 — 실행 계층이 별도로 검증 |
| 검증 주체 | LLM 자신(신뢰 기반) | 플랫폼의 결정론적 실행 엔진 + 권한 시스템 |
정의되지 않은 관계를 “요청”하는 tool call 자체는 LLM이 텍스트로 만들어낼 수 있다. 하지만 그 요청을 받는 AIP Logic 쪽에 스키마에 없는 함수 호출을 실행할 방법이 없다 — 존재하지 않는 함수를 부르는 것과 같다.
벡터·시맨틱 레이어는 어디에 있는가
별도의 외부 벡터DB가 온톨로지 옆에 붙어있는 구조가 아니다. Vector가 온톨로지 자체의 Property Type 중 하나다.
- Pipeline Builder의
Text to Embeddings표현식으로 팔란티어 제공 모델(예: text-embedding-ada-002)을 통해 텍스트를 벡터로 변환한다. - Object Type 설계 시 프로퍼티 타입을
Vector로 지정하고, 차원(dimension)과 유사도 함수(similarity function)를 설정한다. - 벡터 임베딩 프로퍼티를 가진 Object Type에 한해, 사용자 질문을 K개의 가장 관련성 높은 오브젝트로 좁히는 시맨틱 검색을 수행한다.
“perform a semantic search to identify the K most relevant objects to a user query, provided that your object type has a vector embedding property.”
— AIP Agent Studio · Retrieval context
즉 ERP Object Type에 벡터 프로퍼티를 별도로 만들지 않았다면, 지금 구조는 순수하게 구조화된(typed) Property·Link 매칭에 의존한다는 뜻이다. 시맨틱 검색은 선택적으로 추가하는 레이어이지, 온톨로지 그라운딩의 필수 전제조건은 아니다.
자연어 질문이 실제 쿼리가 되는 과정
ERP 시나리오(주문·거래처·품목 Object Type, FK가 Link Type으로 등록됨)를 기준으로 정리하면 이렇다.
| 단계 | 시점 | 내용 |
|---|---|---|
| A | 설계 | 주문.거래처ID → 거래처.ID 같은 FK가 주문 —(발주처)→ 거래처 Link Type으로 명시 등록 |
| B | 설계 | cust_addr_1 → 표시이름 “배송지 주소” + 설명(“고객이 등록한 기본 배송 주소”) |
| C | 구성 | 빌더가 “이 AI는 주문·거래처·품목 Object Type과 그 프로퍼티, 주문→거래처 Link를 쓸 수 있다”고 지정 — 내부적으로 표준 function-calling 스키마로 변환 |
| D | 질의 | LLM이 description을 읽고 질문이 어떤 Object Type·Property·Link와 의미적으로 맞는지 스스로 추론 |
| E | 질의 | LLM은 “함수 호출 요청”만 생성 — 직접 실행하지 않는다 |
| F | 실행 | 플랫폼이 권한 검증 후 결정론적으로 실행. 정의 안 된 관계는 애초에 tool 목록에 없어 요청 자체가 불가능 |
| G | 응답 | 결과가 충분하면 근거와 함께 답변 생성, 부족하면 다른 Link를 타고 추가 호출 |
RDB는 SQL 엔진이 즉석에서 테이블을 JOIN하지만, 온톨로지는 관계를 미리 이름 붙인 함수(도구)로 등록해두고 LLM은 그중 골라 파라미터만 채워 호출한다. 트래버스(탐색) 기능 자체는 Object Type을 설계하는 시점에 이미 함수로 만들어져 있다 — LLM이 이 로직을 직접 짜는 게 아니라, 시맨틱 레이어(description·이름)를 근거로 “어떤 함수를, 어떤 파라미터로, 어떤 Link를 타고 호출할지”만 판단한다.
다단계(멀티홉) 질문은 함수 호출을 반복해서 푼다
답이 한 번의 조회로 안 나오고 여러 단계(홉)를 거쳐야 하는 질문 — 예: “이 거래처가 최근 주문한 품목 중 재고 부족한 게 있어?”(거래처→주문→품목→재고, 3홉) — 은 LLM이 “함수 호출 → 결과 관찰 → 다음 함수 호출”을 반복하는 에이전트 루프로 처리된다. 한 번의 SQL처럼 전체 조인이 미리 계획되는 게 아니라, 사람이 오브젝트를 한 홉씩 클릭해 트래버스하듯 LLM이 매 단계 결과를 보고 다음 호출을 그때그때 결정한다.
- 1차 호출: “거래처 X와 연결된 주문 가져와” (거래처→주문 Link)
- 결과(주문 목록)가 새 컨텍스트로 반환됨
- 2차 호출: “이 주문들과 연결된 품목 가져와” (주문→품목 Link)
- 3차 호출: “이 품목들의 재고 수준 가져와” (품목→재고 Link)
- 충분해지면 호출을 멈추고 누적된 결과로 최종 답변 작성
몇 단계를 거칠지·어떤 순서로 탐색할지는 LLM이 실행 시점에 동적으로 결정하지만, 탐색 가능한 경로 자체는 빌더가 미리 정의한 Link Type 그래프로 제한된다 — 매 홉이 여전히 실제로 등록된 Link Type만 탈 수 있고, 매 호출이 AIP Logic의 실행·권한 레이어를 통과한다는 원칙이 다단계에서도 동일하게 적용된다. (한 번의 에이전트 턴 안에서 이 반복에 최대 스텝 제한이 있는지는 공식 문서로 명시적으로 확인되지 않았다.)
원본 테이블을 통째로 읽어서 답하는가?
아니다. 막히는 것과 되는 것을 구분해야 한다.
- 막히는 것 — 원본 레코드를 컨텍스트에 통째로 쏟아붓는 것. LLM이 보는 건 허가된 Property만 노출된 스키마이며, 실제 데이터도 구조화된 필터 호출로만 가져온다. 토큰 효율을 위한 반환 객체 수 제한(return limit)도 빌더가 미리 설정 가능하다.
- 되는 것 — 필터링된 전체 범위에 대한 집계(aggregation). “이번 달 전체 주문 매출 합계”처럼 넓은 범위를 대상으로 한 집계는 가능하다. 다만 이때도 개별 레코드를 하나하나 LLM 컨텍스트로 끌어오는 게 아니라, 플랫폼이 내부적으로 계산해 결과값 하나만 반환한다.
전체 처리 흐름 — 5개 계층
독립 기술분석(zerofuturetech)이 공식 문서를 종합해 정리한 구조다.
- Context (자동·결정론적) — 고정 오브젝트 세트 / 시맨틱 검색(Vector 프로퍼티가 있는 경우) / 문서 컨텍스트 / 커스텀 조회 함수 → 전체 스키마가 아닌 허가된 일부만 컨텍스트 텍스트로 생성
- Query (LLM이 호출) — 허가된 Object Type·Property만 조회. 필터·집계·정의된 Link만 탐색. 임의 JOIN·미정의 관계 추론 불가
- Logic (LLM이 호출) — 게시된 Function 호출. 비즈니스 규칙·ML 모델·또 다른 LLM 단계. 여기서는 임의의 계산·추론이 자유롭다
- Action (거버넌스형 쓰기) — 파라미터 검증 + 권한 확인. 저위험은 자동 실행, 고위험은 사람 승인 대기
- Governance (전 계층 관통) — 행·열 단위 접근제어, 감사로그, 계보추적. “환각 방지”는 프롬프트 지시가 아니라 애초에 못 보게 막는 접근 통제로 구현된다
MCP로 접속할 때는 다른가
Claude 같은 외부 LLM을 MCP로 온톨로지에 연결하면 안전장치가 사라질까 — 관건은 “MCP냐 AIP냐”가 아니라 어떤 도구가 노출되느냐다.
- 공식 Ontology MCP(OMCP) — 팔란티어 공식 문서는 “Ontology MCP makes your application’s ontology resources (such as object types, action types, and query functions) available as MCP tools”라고 밝힌다. 즉 AIP와 똑같이 구조화된 함수(도구) 형태로 노출되므로, 정의된 관계만 탐색 가능하고 권한 필터링도 동일하게 적용된다. MCP는 그 도구들을 표준 프로토콜로 포장한 통로일 뿐이다.
- 제3자 MCP 서버가 “SQL 실행” 도구를 노출하는 경우 — 커뮤니티에서 만든 일부 Foundry MCP 서버는 “온톨로지 데이터 상호작용과 SQL 쿼리 실행”을 함께 제공한다고 명시한다. 이 경우 LLM이 description만 참고자료로 삼고 SQL을 직접 작성하게 되므로, 잘못된 JOIN이나 정의되지 않은 관계 추론이 실제로 발생할 수 있다. 이건 온톨로지 구조의 문제가 아니라 그 MCP 서버가 어떤 도구를 노출했는지의 문제다.
알아두면 좋은 함정 6가지
- “온톨로지 전체”가 아니라 “허가된 부분집합” — 실제 배치에서는 “이 챗봇은 5개 Object Type, 30개 Property만 접근 가능”처럼 스코프가 좁게 잡힌다.
- description → LLM 경로는 표면(surface)마다 다르다 — AIP Logic에서는 명시되어 있지만, 다른 표면(Agent Studio, AIP Analyst)에서도 동일 메커니즘이라고 통일 서술된 공식 문서는 확인되지 않았다.
- 제한되는 건 “관계 구조”이지 “추론 능력”이 아니다 — Function/AIP Logic 안에서는 임의 코드·ML모델·조건부 로직 실행이 자유롭다. 막히는 건 “정의 안 된 관계 탐색”과 “권한 밖 데이터 열람” 두 가지뿐이다.
- 벡터 검색이 완전히 빠진 게 아니다 — Context 계층의 시맨틱 검색 모드는 벡터 임베딩 기반이다. “순수 그래프만 쓴다”는 이해는 초기 검색 단계를 놓친 것이다.
- “환각 방지”는 절대적 보장이 아니다 — Ontology Augmented Generation(OAG)은 할루시네이션을 줄이지만 완전히 없애지는 않는다.
- 온톨로지 자체가 틀리면 그대로 틀린 답이 나온다 — 잘못 모델링된 온톨로지 위에서는 아무리 정확히 탐색해도 결과가 틀릴 수 있다(garbage-in-garbage-out). “The Ontology is not magic.”
마무리
- ERP 테이블을 Object Type + Link Type으로 옮기는 작업은 단순 마이그레이션이 아니라, AI가 “무엇을 물어볼 수 있고 무엇을 물어볼 수 없는지”를 스키마 레벨에서 미리 확정하는 작업이다.
- description의 품질과 Link Type이 실제 업무 관계와 일치하는지가 답변 정확도를 좌우한다 — 구조가 안전해도 온톨로지 자체가 잘못 모델링되어 있으면 결과는 틀릴 수 있다.
- 다단계 질문도 “한 번의 마법 같은 쿼리”가 아니라, 정의된 Link를 따라 함수 호출을 반복하는 눈에 보이는 루프로 처리된다는 점이 이 구조의 핵심 안전장치다.
참고자료
- Palantir, The Ontology system
- Palantir, Object and link types · Properties · Metadata reference
- Palantir, AIP Agent Studio · Tools Overview
- Palantir, AIP Logic · Overview
- Palantir, AIP Logic · Core concepts
- Palantir, Ontology Augmented Generation / AIP Analyst Overview
- Palantir, Semantic search — Using Palantir-provided models
- Palantir, AIP Agent Studio · Retrieval context
- Palantir, Ontology MCP · Overview
- zerofuturetech, “Palantir AIP Agent-Ontology Interaction: A Deep Dive into the Five-Layer Enterprise AI Architecture” (2026-07-04)
- Akash Dogra, Towards AI, “Inside Palantir AIP: How the World’s Most Controversial AI Platform Actually Works” (2026-05-29)