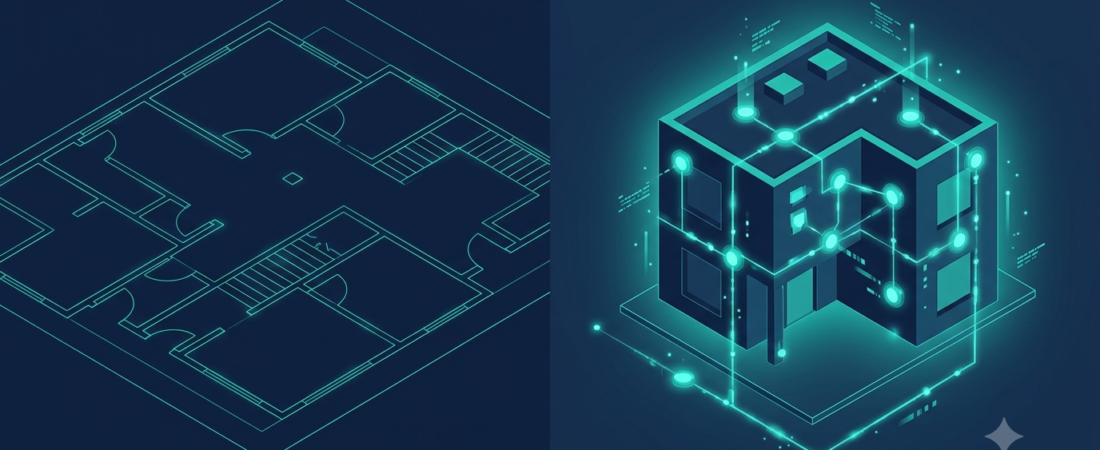
설계도 한 장과, 그 설계도대로 지어진 건물은 다른 것이다
온톨로지와 지식그래프, 뭐가 다른 건가요
이 질문을 자주 받습니다. 둘 다 “관계로 데이터를 이해한다”는 말을 쓰다 보니 같은 걸 다르게 부르는 것처럼 보이기도 합니다. 결론부터 말하면 관계는 이렇습니다.
온톨로지(설계도) + 실제 데이터 = 지식그래프(완공된 건물)
온톨로지는 “책 → 저자를 가진다 → 저자”처럼 어떤 종류의 것들이 있고, 그것들이 어떤 관계를 맺을 수 있는지를 정의하는 틀이다. 지식그래프는 그 틀 위에 실제 데이터를 채워서 “『앵무새 죽이기』 → 저자를 가진다 → 하퍼 리”처럼 구체적인 사실들의 그물망을 만든 것이다.[1] 온톨로지가 없어도 지식그래프는 만들 수 있지만, 온톨로지가 있으면 새로운 데이터가 들어올 때 그 틀에 맞춰 일관되게 연결할 수 있다.
그런데 팔란티어는 왜 굳이 “온톨로지”라는 옛날 철학 용어를 다시 꺼냈을까
여기서 헷갈리는 지점이 하나 더 있다. 이 블로그에서 계속 다루는 팔란티어의 “온톨로지”는, 방금 설명한 학술적 의미의 온톨로지와도 완전히 같지는 않다.
전통적인 시맨틱 웹 관점의 온톨로지는 RDF·OWL 같은 표준으로 정의되고, 용도는 “질의(Query) → 추론(Reasoning) → 결과(Result)”로 끝나는 읽기 중심 구조다.[2] 설계도를 보고 “이 건물 3층에 뭐가 있어?”라고 묻는 것과 비슷하다.
팔란티어의 온톨로지는 여기서 한 단계 더 나간다. Semantic(의미) 계층 위에 Kinetic(실행) 계층을 얹어서, 조회에서 그치지 않고 실제 업무 Action을 실행하고, 그 결과를 다시 학습에 반영하는 순환 구조를 만든다.[2] 같은 건물 비유를 이어가면, 설계도만 보는 게 아니라 그 건물에 센서를 달아서 실시간으로 온도를 조절하고, 조절한 결과가 좋았는지 나빴는지를 다시 시스템이 배우는 식이다.
세 가지를 나란히 놓고 보면
| 구분 | 학술적 온톨로지 | 지식그래프 | 팔란티어 온톨로지 |
|---|---|---|---|
| 역할 | 설계도 — 어떤 종류가 있는지 정의 | 완공된 건물 — 구체적 사실의 그물망 | 센서가 달린 건물 — 실행하고 학습 |
| 표준 | RDF, OWL | 온톨로지 + 인스턴스 데이터 | Object Type / Link Type / Action Type |
| 동작 방식 | 질의 → 추론 → 결과(종료) | 질의 → 결과 | 실행 → 기록 → 학습(순환)[2] |
| 대표 질문 | “이 관계가 논리적으로 성립하는가?” | “하퍼 리가 쓴 책은 무엇인가?” | “이탈 위험 고객에게 지금 무엇을 실행할까?” |
세 가지는 경쟁 관계가 아니라 겹치는 개념이다. 팔란티어의 온톨로지도 내부적으로는 지식그래프처럼 Object(인스턴스)와 Link(관계)의 그물망을 갖고 있고, 그 위에 Action이라는 실행 계층이 하나 더 얹혀 있는 구조로 이해하면 된다.
RDB와 비교하면 오히려 더 잘 들어온다
이 블로그의 다른 글에서 이미 RDB 조인 vs 온톨로지 탐색을 법인카드 한도 조회 예시로 비교한 적이 있다. 그 글의 논리를 그대로 가져오면 지식그래프와의 관계도 정리된다.
- RDB: 관계를 매번 JOIN으로 다시 계산한다. 설계도가 없어도 동작하지만, 같은 질문도 매번 새로 풀어야 한다.
- 지식그래프: 관계를 미리 그래프로 저장해둔다. “누가 누구와 연결되어 있나”를 훨씬 빠르게 찾는다.
- 온톨로지(설계도): 그 관계가 애초에 왜 존재하는지, 어떤 종류끼리 연결될 수 있는지를 미리 정의해서 지식그래프가 일관되게 자라도록 만든다.
- 팔란티어 온톨로지: 여기에 “그래서 지금 뭘 할까”라는 실행 계층까지 붙인다.
네 가지를 계단처럼 놓고 보면, “저장 방식(RDB) → 관계의 그물망(지식그래프) → 그 그물망의 설계 규칙(온톨로지) → 그 위에서 실행까지(팔란티어 온톨로지)”로 이어지는 흐름이다.
실무에서 헷갈리지 않으려면
“우리도 지식그래프 있으니까 온톨로지는 필요 없다”는 흔한 오해다. 지식그래프만 있고 온톨로지(설계 규칙)가 없으면, 데이터가 늘어날수록 같은 개념을 다른 이름으로 부르는 문제가 반복된다. 이 블로그의 온톨로지 네이밍 전략 글이 다루는 문제가 정확히 이거다.
“온톨로지를 만들었으니 지식그래프는 자동으로 따라온다”도 오해다. 설계도만 그려놓고 실제 데이터를 채워 넣지 않으면 아무것도 조회할 수 없다. 온톨로지는 틀이고, 지식그래프는 그 틀에 실제로 데이터를 채우는 작업이다.
“팔란티어 온톨로지 = 학술적 온톨로지”라고 생각하면 AIP를 오해하게 된다. 팔란티어 문서를 읽을 때 “추론(Reasoning)”이라는 단어가 나오면, 이건 순수 논리적 추론이 아니라 데이터 기반 판단과 Action 실행까지 포함하는 더 넓은 의미로 쓰이는 경우가 많다.
정리하면
온톨로지는 설계도, 지식그래프는 그 설계도로 지어진 건물이다. 팔란티어의 온톨로지는 여기서 한 걸음 더 나가, 그 건물에 센서를 달아 실행하고 학습하게 만든 것이다. 셋 중 뭐가 더 나은가를 고를 문제가 아니라, 지금 풀려는 문제가 “무엇이 있는지 정의하는 것”인지, “무엇이 연결되어 있는지 찾는 것”인지, “그래서 지금 뭘 실행할 것인지”인지에 따라 필요한 계층이 다르다.
자주 묻는 질문
Q. 지식그래프 없이 온톨로지만 있어도 되나요? 가능은 하지만 실용성이 떨어집니다. 온톨로지는 규칙만 정의할 뿐, 실제로 조회하거나 분석할 데이터는 지식그래프(인스턴스)에 있습니다. 규칙만 있고 데이터가 없으면 활용할 게 없습니다.
Q. Neo4j 같은 그래프 데이터베이스도 온톨로지인가요? 아닙니다. 그래프 데이터베이스는 지식그래프를 저장하는 기술(그릇)이고, 온톨로지는 그 안에 담기는 데이터의 의미 규칙입니다. 온톨로지 없이도 그래프 DB는 쓸 수 있지만, 그러면 규칙 없이 데이터를 쌓는 셈이 됩니다.
Q. 팔란티어를 안 쓰면 “실행하는 온톨로지”는 못 만드나요? 꼭 그렇지는 않습니다. 온톨로지·지식그래프 위에 별도의 워크플로우 자동화나 액션 실행 계층을 직접 붙이면 비슷한 구조를 만들 수 있습니다. 다만 팔란티어는 이 세 계층(의미·실행·학습)을 하나의 플랫폼 안에서 기본 제공한다는 점이 다릅니다.
참고자료
[1] Enterprise Knowledge, What’s the Difference Between an Ontology and a Knowledge Graph?
[2] Pebblous, What Is Palantir Ontology? — 5 Key Differences from Classic Ontology