이 글은 누구를 위한 것인가
팔란티어 뉴스를 보고 “온톨로지”라는 단어를 처음 접한 분, ERP나 데이터 분석 배경이 있어서 “이게 결국 데이터 모델링 아닌가” 싶은 분, 혹은 이미 온톨로지를 구축 중인데 왜 이렇게 만드는지 원칙이 궁금한 분 모두를 대상으로 합니다. 주가나 투자 판단과는 무관하며, 실무자의 입장에서 온톨로지가 기술적으로 무엇이고 왜 중요한지를 정리한 글입니다.
사전적 정의의 함정
‘온톨로지’를 검색하면 가장 먼저 나오는 건 철학 용어입니다. “존재론” — 세상에 무엇이 존재하는지, 그 존재들이 어떤 범주로 나뉘는지를 다루는 철학의 한 분야죠. 실제로 온톨로지라는 용어 자체가 이 철학적 전통에서 왔고, OWL·RDF 같은 온톨로지 언어들도 그 영향을 받았습니다. 다만 이 정의를 그대로 들고 팔란티어의 온톨로지를 이해하려 하면 오히려 헷갈립니다 — 기업 데이터 분야에서는 훨씬 실용적인 의미로 쓰이기 때문입니다.
컴퓨터 과학, 특히 기업 데이터 분야에서 말하는 온톨로지는 훨씬 실용적인 개념입니다. 철학적 사유의 대상이 아니라, 회사가 다루는 실제 업무를 소프트웨어가 이해할 수 있는 형태로 옮겨놓은 모델입니다.
실무 정의: 회사의 현실을 소프트웨어가 이해하는 지도로
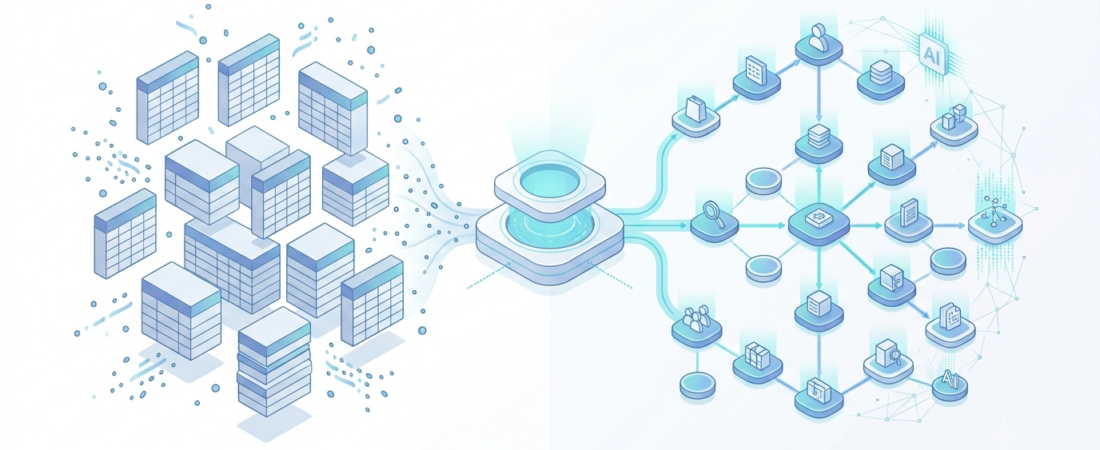
풀어서 설명하면 이렇습니다. 온톨로지는 회사 안에 존재하는 것들(고객, 주문, 제품, 설비 같은 “객체”)과, 그것들 사이의 관계(이 고객이 이 주문을 냈다, 이 제품이 이 설비에서 생산됐다), 그리고 그 위에서 일어나는 행동(주문을 승인한다, 재고를 이동한다)을 하나의 구조로 정리해놓은 것입니다.
한마디로 정리하면: 온톨로지는 회사의 현실(객체·관계·행동)을 소프트웨어와 AI가 이해할 수 있게 옮겨놓은 지도입니다.
테이블로 볼 때와 온톨로지로 볼 때
이 차이를 가장 잘 보여주는 예시가 흔한 업무 데이터, 예를 들어 주문-고객-제품-배송입니다.
일반적인 관계형 데이터베이스(RDB)에서는 이 정보가 각각 별도의 테이블에 저장돼 있습니다. 고객 테이블, 주문 테이블, 제품 테이블, 배송 테이블이 따로 존재하고, 이들을 연결하려면 외래키를 따라가며 조인(JOIN)을 해야 합니다. 뷰나 시맨틱 레이어로 이런 조인을 어느 정도 재사용하는 경우도 있지만, 새로운 질문이 나올 때마다 결국 사람이 관계를 다시 설계해야 하는 경우가 많습니다. AI 입장에서는 스키마·문서·쿼리 이력 등에서 관계를 어느 정도 추론할 수는 있어도, 그게 실제 업무에서 어떤 의미인지까지 확신 있게 알아내기는 어렵습니다.
온톨로지 관점에서는 이 그림이 달라집니다.
온톨로지에서의 관계 (텍스트로 정리)
- 고객 — 주문했다 → 주문
- 주문 — 포함한다 → 제품
- 주문 — 배송된다 → 배송
- 배송 — 담당한다 → 배송기사
고객, 주문, 제품, 배송은 각각 독립된 테이블이 아니라 “객체(Object)”가 되고, 그 사이의 화살표는 미리 정의된 “관계(Link)”가 됩니다. 이렇게 정의해두면 “이 고객이 최근 주문한 제품 중 배송이 지연된 게 있는지” 같은 질문이, 매번 새로운 SQL을 짜는 게 아니라 이미 정의된 관계를 따라가는 탐색이 됩니다.
이 매핑을 조금 더 구체적으로 보면 이렇습니다. 데이터베이스 안에서는 TB_CUSTOMER, TB_ORDER, CUST_ID, ORDER_DT처럼 기술적인 이름이 쓰이지만, 온톨로지에서는 이걸 각각 고객(Customer), 주문(Order), 고객 ID, 주문일처럼 실제 업무에서 쓰는 용어로 다시 정의합니다. 단순히 이름만 바꾸는 게 아니라 각 항목에 설명을 붙이고, 코드값이나 속성값도 별도의 객체로 정의해서 의미를 부여합니다. 그 결과 조인으로만 존재하던 테이블 간 연결이 “고객이 주문한다”, “주문이 제품을 포함한다”처럼 사람이 이해하는 업무 관계로 승격됩니다.
비슷해 보이는 개념들과 무엇이 다른가
온톨로지를 처음 접하면 “이거 결국 데이터 카탈로그 아니야?”, “시맨틱 레이어랑 뭐가 달라?”라는 질문이 자연스럽게 나옵니다. 넷 다 “데이터에 의미를 부여한다”는 목적은 같지만, 다루는 범위가 다릅니다.
| 개념 | 주로 다루는 것 | 온톨로지와의 차이 |
|---|---|---|
| 데이터 카탈로그 | 어떤 데이터가 어디 있는지(메타데이터, 출처, 소유자) | 데이터를 “찾는” 도구에 가깝고, 객체 간 관계나 행동은 다루지 않음 |
| 비즈니스 용어집(Glossary) | 용어의 정의를 통일 | 용어 정의는 겹치지만, 용어 사이의 구조적 관계나 실행 가능한 액션은 없음 |
| 지식 그래프(Knowledge Graph) | 개체와 관계를 그래프로 표현 | 온톨로지와 가장 가깝지만, 온톨로지는 여기에 “행동(Action)”까지 얹어 실제 시스템 변경을 일으킬 수 있다는 점이 다름 |
| 시맨틱 레이어 | BI 도구에서 쓰는 지표·차원 정의 | 분석·리포팅 목적에 특화되어 있고, 온톨로지처럼 애플리케이션이나 AI 에이전트의 실행 기반으로 쓰이지는 않음 |
즉 온톨로지는 이 네 가지 개념의 좋은 부분(메타데이터, 용어 통일, 관계 그래프, 지표 정의)을 어느 정도 포괄하면서, 그 위에 “행동(Action)”이라는 층을 더해 AI와 애플리케이션이 실제로 무언가를 실행할 수 있는 기반까지 제공한다는 점에서 한 단계 더 나아간 개념입니다.
왜 지금 이게 중요한가
요즘 기업들은 코딩·문서 요약 같은 개인 생산성 AI는 빠르게 도입하고 있습니다. 그런데 “우리 회사 데이터를 넣고 물어보면 알아서 분석해주는 AI”는 생각보다 잘 작동하지 않습니다. 이유는 간단합니다. LLM은 언어는 잘 이해하지만, 회사 내부의 고객, 주문, 제품 같은 테이블이 실제로 무엇을 의미하고 서로 어떻게 연결되는지는 전혀 모르기 때문입니다.
온톨로지는 이 간극을 메우는 방법입니다. 데이터에 “의미”를 미리 입혀두면, AI는 테이블 이름과 컬럼을 추측하는 대신 이미 정의된 객체와 관계를 따라 정확한 답을 찾을 수 있습니다.
언제 온톨로지가 필요하고, 언제는 아닌가
모든 조직에 온톨로지가 필요한 것은 아닙니다. 적용을 판단할 때는 다음 기준이 도움이 됩니다.
- 여러 시스템에 흩어진 데이터를 하나의 관점으로 봐야 하는가: ERP, CRM, 자체 시스템에 흩어진 고객·주문 데이터를 하나의 화면이나 하나의 AI 질의로 다뤄야 한다면 온톨로지의 이점이 큽니다. 시스템이 하나뿐이고 조회 패턴도 단순하다면, 온톨로지 구축 비용이 이득보다 클 수 있습니다.
- 같은 질문을 반복해서 받는가: “이번 달 재고 부족 위험 제품은?”처럼 반복되는 분석 요청이 있다면, 그 질문에 필요한 객체·관계를 온톨로지로 한 번 정의해두는 편이 매번 새로 SQL을 짜는 것보다 이득입니다. 일회성 분석이라면 배보다 배꼽이 커집니다.
- AI에게 실행 권한까지 주고 싶은가: 단순 조회를 넘어 AI가 “재고를 이동한다”, “주문을 승인한다”처럼 실제 행동까지 하길 원한다면 온톨로지의 Action Type이 꼭 필요합니다. 조회만으로 충분하다면 온톨로지 없이도 RAG 수준에서 해결되는 경우가 많습니다.
실무에서 느낀 것
운영을 맡게 된 프로젝트에는 이미 여러 온톨로지가 구축되어 있었고, 이를 활용한 화면도 상당히 만들어져 있는 상태였습니다. 다만 보안상의 이유로 외부 AI를 연결할 수 없어서, 그동안은 온톨로지가 AI와 결합했을 때 실제로 어떤 성능을 내는지 확인해볼 기회가 없었습니다.
최근 외부 AI가 개인 사용자에게도 열리면서, 팔란티어의 Ontology MCP를 통해 기존 온톨로지를 활용한 분석을 직접 시도해봤습니다. 그런데 막상 해보니 예상과 달랐습니다. 이미 만들어진 온톨로지의 오브젝트·속성 이름이 비즈니스 용어로 잘 정리되어 있지 않았고, 관계(Link)도 지나치게 많은데 각각이 어떤 의미인지 명확하지 않아서, 실무자인 저조차 이걸 보고 분석하기가 쉽지 않았습니다. AI가 찾아준 결과도 만족스럽지 못했습니다.
이 경험에서 얻은 교훈은 분명했습니다. 온톨로지를 설계할 때는 처음부터 기술 용어가 아니라 실제 업무에서 쓰는 비즈니스 용어로 모델링해야 하고, 관계도 무작정 단계를 늘리기보다 화면 설계와 모델링을 함께 반복하면서 꼭 필요한 만큼만 구성해야 한다는 걸 절감했습니다. 온톨로지 설계 자체를 도와주는 기능이 있으면 좋겠다는 생각도 들었습니다 — 테이블을 넣으면 필드를 비즈니스 용어로 먼저 제안해주고, 사람이 확인·수정할 수 있게 하고, 관계도 함께 제안해주는 식으로요. 여기서 한 가지 더 중요하게 느낀 건, 이름을 영문 우선으로 정의하고 국문은 보조로 붙이는 방식이 AI 성능에도 실제로 도움이 된다는 점이었습니다.
자주 반복되는 실무 실패 패턴
여러 온톨로지를 검토하고 직접 설계해보면서 반복적으로 발견한 패턴은 다음과 같습니다.
- 기술 용어를 그대로 온톨로지 이름으로 쓰기:
CUST_MST_TB,ORD_STAT_CD같은 원본 컬럼명을 그대로 Property명으로 쓰면, AI든 사람이든 그 의미를 추측해야 합니다. 온톨로지의 가치는 이 추측을 없애는 데 있는데, 이름을 그대로 옮기면 그 가치가 사라집니다. - 관계를 일단 다 만들고 보기: “혹시 필요할지 모르니” 관계를 과도하게 만들면, 정작 필요한 관계가 무엇인지 알아보기 어려워집니다. 관계는 실제 업무 질문에서 역산해서 필요한 만큼만 만드는 것이 원칙입니다.
- 설계와 화면 제작을 분리해서 순차적으로 진행하기: 온톨로지를 완벽히 설계한 다음 화면을 만들겠다는 접근은 실무에서 잘 작동하지 않습니다. 실제 화면(Workshop 등)을 만들면서 어떤 속성이 정말 필요한지가 드러나기 때문에, 설계와 화면 제작을 병행하며 반복하는 편이 더 정확합니다.
마무리
온톨로지는 철학 용어를 컴퓨터 과학에 억지로 끌어온 것이 아니라, “회사의 현실을 AI가 이해할 수 있게 만드는 방법”이라는 아주 실용적인 문제에서 출발한 개념입니다.
다음으로 읽을 글
객체·관계·행동이 실제로 어떻게 구성되는지 더 자세히 보려면 온톨로지 핵심 구성요소를, 이름을 어떻게 표준화해야 하는지는 온톨로지 네이밍 전략을, 실제로 Foundry에서 온톨로지를 만드는 절차는 Ontology Manager 실전 가이드를 이어서 확인해보세요. 이 개념이 왜 챗봇형 기업 AI의 한계와 연결되는지는 기업 AI가 챗봇에서 멈추는 이유에서 다룹니다.
자주 묻는 질문
Q. 온톨로지와 데이터 모델은 뭐가 다른가요?
데이터 모델은 데이터를 어떻게 저장할지에 초점을 맞추지만, 온톨로지는 저장된 데이터를 실제 업무 개념(객체·관계·행동)으로 다시 매핑해서 사람과 AI가 같은 언어로 이해하고 조작할 수 있게 만든 것입니다. 데이터 모델 위에 한 겹 더 올라간 의미 계층이라고 보면 됩니다.
Q. 온톨로지와 지식그래프(Knowledge Graph)는 같은 건가요?
둘 다 객체와 관계를 그래프로 표현한다는 점은 비슷하지만, 팔란티어 온톨로지는 조회용 그래프에 그치지 않고 Action Type을 통해 승인·이동 같은 실제 업무 행동을 실행할 수 있다는 점이 다릅니다.
Q. 온톨로지가 왜 AI(특히 LLM)에 필요한가요?
LLM은 기업 고유의 데이터 구조를 모르기 때문에 프롬프트만으로는 정확한 답을 만들기 어렵습니다. 온톨로지는 이 구조를 명시적으로 정의해서 LLM이 참조할 신뢰 가능한 컨텍스트를 제공하고 할루시네이션을 줄이는 역할을 합니다.
Q. 온톨로지는 항상 필요한가요?
아닙니다. 데이터가 단순하고 부서 간 재사용 요구가 적다면 기존 테이블·BI 구조로도 충분합니다. 여러 시스템의 데이터를 통합해서 AI나 여러 애플리케이션이 함께 참조해야 하는 상황일 때 온톨로지의 이점이 커집니다.
Q. 온톨로지 구축은 어디서부터 시작하나요?
전체 데이터를 한 번에 온톨로지화하려 하지 말고, 명확한 비즈니스 가치가 있는 좁은 범위(하나의 프로세스나 부서)부터 Object Type을 정의하며 시작하는 것이 일반적으로 권장됩니다.