코드를 짠 에이전트가 그 코드를 통과시켰다
에이전트 하나에게 “이 기능을 구현하고, 구현이 끝나면 스스로 검토해서 문제없으면 병합해줘”라고 맡겼다고 해봅시다. 이 에이전트는 코드를 작성하고, 그 코드를 다시 자신이 검토합니다. 결과는 예상 가능합니다. 웬만하면 “문제없음”으로 통과시킵니다. 자기가 방금 쓴 코드를 스스로 비판적으로 보기는 어렵기 때문입니다. 사람도 마찬가지지만, 에이전트도 같은 함정에 빠집니다.
에이전트 하나로는 부족한 이유
이 문제는 두 가지로 나뉩니다.
컨텍스트 과부하. 조사, 중간 코드, 대화 기록이 쌓이면서 정작 지금 필요한 정보가 흐려집니다. 대화가 길어질수록 에이전트는 앞에서 확인했던 세부사항을 놓치기 시작합니다.
역할 충돌. 작성자와 검증자가 같은 에이전트면, 자기 작업을 편향적으로 승인하는 문제가 생깁니다. 앞서 예로 든 코드 리뷰 사례가 정확히 이 경우입니다.
기본 구조: Orchestrator와 Subagent
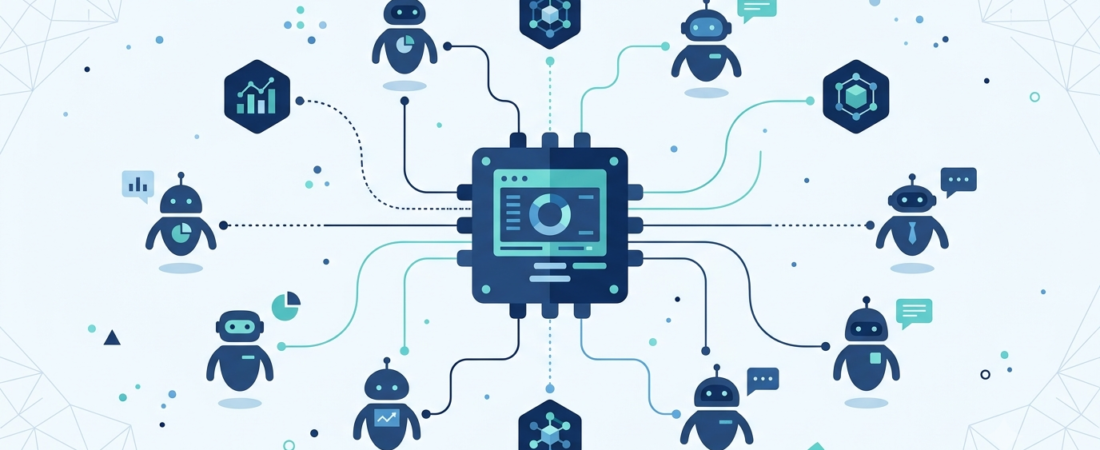
이 문제에 대한 답이 멀티 에이전트 구조입니다. 역할을 나눕니다.
- Orchestrator: 작업을 나눠서 배분하고 결과를 취합합니다. 사용자와의 접점도 Orchestrator가 담당합니다.
- Subagent: 제한된 범위의 작업만 수행합니다. 독립된 컨텍스트 창을 갖고 있어서, 다른 Subagent의 작업에 영향을 받지 않습니다. 결과는 요약해서 Orchestrator에게 돌려줍니다.
코드 리뷰 사례라면 이렇게 나눌 수 있습니다. 코드를 작성하는 Subagent 하나, 그 코드를 검토하는 Subagent를 별도로 둡니다. 검토 Subagent는 코드 작성 과정을 지켜보지 않았기 때문에, “이 코드가 왜 이렇게 짜였는지”에 대한 선입견 없이 결과물만 놓고 판단합니다. 자기 편향 문제가 구조적으로 사라집니다.
병렬로 할까, 순차로 할까
병렬 실행이 맞는 경우는 작업이 서로 독립적일 때입니다. 예를 들어 “라이브러리 A, B, C를 각각 조사해서 비교해줘”라면, 세 Subagent가 동시에 조사해도 서로 영향을 주지 않습니다. 다만 여러 에이전트가 동시에 같은 파일을 수정하려 하면 충돌이 생기므로, 파일을 함께 건드리는 작업은 병렬로 돌리면 안 됩니다.
순차 실행이 맞는 경우는 이전 단계의 결과가 다음 단계의 입력으로 필요할 때입니다. 코드 작성 → 코드 리뷰 → 수정 반영은 순서가 있어야 합니다. 다만 순차 실행은 각 단계마다 결과를 주고받는 데 시간이 들기 때문에, 필요 이상으로 잘게 쪼개면 오히려 느려집니다.
자주 나타나는 실패 패턴
과도한 분할로 오버헤드가 커진다. 간단한 작업까지 여러 Subagent로 쪼개면, 작업을 나누고 결과를 합치는 데 드는 비용이 실제 작업보다 커집니다.
요약이 부실해서 컨텍스트가 손실된다. Subagent가 결과를 Orchestrator에게 넘길 때 핵심을 빠뜨리면, Orchestrator는 불완전한 정보로 다음 판단을 내리게 됩니다.
암묵적 의존성을 놓치고 병렬 처리한다. 겉보기엔 독립적인 것 같아도, 실제로는 같은 설정 파일을 참조하는 등 숨은 의존성이 있으면 병렬 실행 시 충돌이 납니다.
개별 오류를 걸러내지 않고 결과를 취합한다. 한 Subagent가 실패하거나 이상한 결과를 냈는데, Orchestrator가 이를 검증 없이 그대로 최종 결과에 반영하면 오류가 그대로 전파됩니다.
도입 여부를 판단하는 기준
멀티 에이전트가 항상 정답은 아닙니다. 다음 질문에 답해보세요.
- 지금 단일 에이전트의 컨텍스트가 실제로 부족한가?
- 역할을 분리했을 때 품질이 실제로 개선될 것 같은가? (코드 리뷰 사례처럼 자기 편향이 문제라면 그렇습니다)
- 병렬 처리로 절약되는 시간이, 여러 에이전트를 조율하는 데 드는 오버헤드보다 큰가?
세 질문에 모두 그렇다는 답이 나올 때 멀티 에이전트 구조를 도입하는 게 맞습니다. 단순한 작업까지 여러 에이전트로 쪼개는 건 오히려 비효율적입니다.
정리하면
에이전트 하나에게 작성과 검증을 동시에 맡기면, 사람이 자기 코드를 스스로 리뷰할 때와 똑같은 함정에 빠집니다. 역할을 분리하고, 작업의 독립성에 따라 병렬과 순차를 구분해서 조합하는 것. 멀티 에이전트 시스템의 핵심은 이 두 가지입니다.
자주 묻는 질문
Q. Orchestrator도 결국 하나의 에이전트인데, 이건 편향 문제가 없나요? Orchestrator는 직접 작업을 수행하지 않고 배분·취합만 담당하기 때문에, 작성자-검증자 편향 문제와는 성격이 다릅니다. 다만 Orchestrator가 Subagent의 결과를 검증 없이 그대로 취합하면 다른 종류의 오류가 생길 수 있으니, 결과 취합 단계에도 검증 로직을 넣는 게 안전합니다.
Q. Subagent는 몇 개까지 두는 게 적당한가요? 정해진 답은 없습니다. 작업을 독립된 단위로 나눴을 때 자연스럽게 나오는 개수를 따르되, 관리 가능한 범위(보통 서너 개 내외)를 넘어가면 오케스트레이션 자체의 복잡도가 커진다는 점을 고려하세요.