요약 — 앞선 글(프롬프트·RAG·파인튜닝 선택 기준)은 문서·이미지 같은 비정형 데이터가 대상이었습니다. 기업의 핵심 데이터는 DB에도 있습니다. “지난달 부서별 휴가 사용률은?” 같은 숫자·집계 질문은 문서를 검색해서는 답할 수 없습니다. 이 글은 같은 가상의 팀이 사내 AI 도우미에 DB를 연결하며 고르는 네 가지 방식 — 도구 호출, Text-to-SQL, 시맨틱 레이어(온톨로지), 요약 문서화 — 의 선택 기준과, 반드시 지켜야 할 권한·보안·평가 원칙을 정리합니다. 특히 같은 데이터라도 참조용이냐 의사결정용이냐에 따라 설계가 달라지고, 의사결정용은 자유 질의를 닫은 채 영역별 플로우를 오케스트레이터가 갈래 태워 서빙하는 방식이 왜 합리적인지를 공개된 벤치마크와 연구에 비추어 설명합니다. (사례는 일반화한 가상 시나리오입니다.)
0. 먼저 결론: 한 장 요약
| 질문 유형 | 예시 | 첫 번째 선택 |
|---|---|---|
| 정해진 조회·집계 | “A 고객의 미결제 주문 합계는?” | 정의된 도구(API) 호출 |
| 자유로운 탐색 질문 | “작년 대비 지역별 증감이 큰 상품은?” | Text-to-SQL (안전장치 필수) |
| 여러 시스템·용어 통합 | “고객”이 CRM과 ERP에서 다른 뜻 | 시맨틱 레이어 / 온톨로지 |
| 정해진 주기의 리포트성 질문 | “월간 요약을 알려줘” | 요약 결과를 문서화해 RAG |
| 숫자 + 규정을 함께 묻는 질문 | “사용률이 낮은 부서와 이월 규정 문제는?” | 오케스트레이터가 DB 플로우와 문서 RAG로 갈래를 태워 합침 |
| 의사결정의 근거가 되는 수치 | “이번 분기 이 지역 인력을 줄일까? 근거는?” | 자유 질의를 닫고 사전 검증된 영역 플로우만 |
핵심 원칙 세 가지 1. 정형 데이터는 “검색해서 읽히는” 것이 아니라 “질의해서 계산하는” 것입니다. LLM은 질의를 만들고 결과를 설명하고, 계산은 DB가 합니다. 2. 같은 데이터도 참조용인지 의사결정용인지에 따라 허용되는 오류와 설계가 달라집니다. (3장) 3. 의사결정용은 자유 질의를 그대로 열지 않고, 영역별 플로우를 만들어 오케스트레이터가 갈래를 태워 서빙합니다. 환각을 “없앤다”기보다 발생 범위를 구조로 좁힙니다. (4장, 8장)
1. 이야기의 이어짐 — 이번에는 숫자를 묻는다
앞선 글의 팀은 사내 규정 도우미를 프롬프트와 RAG로 안정화했습니다. 출시 후 임직원의 질문이 달라집니다.
- “우리 팀 이번 달 휴가 사용률은 몇 %예요?”
- “A 고객의 미결제 주문 합계를 알려줘.”
- “작년 대비 매출이 가장 많이 줄어든 지역 3곳은?”
답은 규정 문서가 아니라 인사·주문·매출 DB의 숫자에 있습니다. 팀의 첫 시도는 자연스럽습니다. “RAG로 잘 됐으니 DB 행도 텍스트로 바꿔 인덱싱하자.” 그리고 곧 실패합니다.
2. 문서 RAG 방식이 DB 질문에서 실패하는 이유
행을 문장으로 바꿔 임베딩하면 세 가지 벽에 부딪힙니다.
- 집계·조인·필터가 필요하다. 합계, 평균, 기간 비교, 상위 N개는 의미 검색이 아니라 계산입니다. 유사한 행 몇 개를 가져와서는 정확한 합계를 낼 수 없습니다. 검색된 20행을 LLM이 머릿속에서 더하면 틀립니다.
- 최신성이 깨진다. DB는 계속 바뀝니다. 임베딩 복사본은 갱신 시점부터 낡고, 동기화 파이프라인이 별도 장애 지점이 됩니다.
- 권한과 정합성. 행·열 단위 접근 통제는 DB가 이미 갖고 있습니다. 복사본을 벡터 DB에 넣는 순간 그 통제가 사라지고, “이 숫자가 어느 정의의 숫자인가”도 흐려집니다.
| 시도 | 결과 | 원인 |
|---|---|---|
| 주문 행을 임베딩해 “A 고객 미결제 합계” 질문 | 일부 행만 검색되어 합계가 틀림 | 집계를 검색으로 해결하려 함 |
| 어제 갱신한 임베딩으로 오늘 재고 질문 | 오래된 수치 | 복사본의 최신성 |
| 서비스 계정으로 전체 데이터를 인덱싱 | 권한 없는 사용자가 타 부서 데이터를 봄 | 접근 통제 소실 |
판단 기준 ④: 답이 “문장을 찾는 것” 이면 RAG, “숫자를 계산하는 것” 이면 질의·도구 호출, “둘 다” 면 에이전트가 소스를 라우팅한다.
3. 먼저 쓰임새를 나눈다 — 참조용인가, 의사결정용인가
같은 DB 질문이라도 그 답이 어디에 쓰이는지에 따라 요구되는 정확도와 검증 방식이 달라집니다. 엄밀히 말하면 모델의 정확도가 달라지는 것이 아니라, 허용되는 오류의 크기와 오류의 비용이 달라지는 것입니다. 그래서 설계도 달라져야 합니다.
| 항목 | 참조용 (이해·탐색) | 의사결정용 (판단·실행의 근거) |
|---|---|---|
| 질문 예 | “지난달 어느 지역이 대략 부진했지?” | “이번 분기 이 지역 영업 인력을 줄일까? 근거 수치는?” |
| 오류의 비용 | 낮음 (다시 확인하면 됨) | 높음 (잘못된 의사결정, 금전·규정 위반) |
| 요구되는 정확도 | 방향성이 맞으면 충분 | 정확한 수치, 정의, 기준 시점 |
| 허용되는 방식 | 제한된 자유 질의 (읽기 전용, “참고용” 표시) | 사전에 검증된 플로우만 |
| 검증 방식 | 사용자가 보고 판단 | 쿼리·지표 정의·출처를 고정하고 재현·감사 가능하게 |
| 답변 형태 | 요약 + 근거 | 정해진 지표 + 정의 + 기준 시점 + 실행된 쿼리 |
왜 의사결정용은 사람의 눈에만 맡기면 안 될까요? 자동화 보조 도구를 다룬 인간공학 연구(Parasuraman & Manzey, 2010)는 보조 도구가 불완전할 때 사용자가 그 결과를 그대로 따르거나 놓치는 자동화 편향(automation bias) 이 전문가에게도 나타나며, 훈련이나 지시만으로는 막기 어렵다고 보고합니다. 이를 LLM 답변에 적용하면(이 연결은 저자의 추론입니다), “틀릴 수 있으니 확인하세요”라는 안내만으로는 의사결정용 답변의 품질을 보장할 수 없고, 틀린 답이 아예 나오기 어려운 구조를 시스템 쪽에서 만들어야 한다는 결론이 됩니다.
판단 기준 ⑤: 먼저 이 답이 참조용인지 의사결정용인지 정한다. 참조용은 제한된 자유 질의를 허용할 수 있고, 의사결정용은 자유 질의를 닫고 검증된 영역별 플로우로만 답한다.
4. 자유 질의를 그대로 열지 않는 이유 — 숫자로 본 근거
“LLM이 SQL을 알아서 만들어 주면 되지 않나?”라는 질문에는 공개된 벤치마크가 답해 줍니다. 아래 수치는 평가 방식과 모델에 따라 달라지고 이후 상당히 개선되었으므로, 절대값보다 패턴을 읽어야 합니다.
| 근거 | 무엇을 측정했나 | 보고된 결과 |
|---|---|---|
| BIRD (NeurIPS 2023) | 대규모 실제 DB 기반 Text-to-SQL | 사람의 실행 정확도 약 93% 대비 당시 GPT-4 약 55%. 외부 지식(증거)을 주면 약 35% → 55% |
| Spider 2.0 | 수백 컬럼 규모의 기업형 스키마와 워크플로 | 당시 최상위 코드 에이전트가 약 21%만 해결 (같은 계열의 Spider 1.0은 91%, BIRD는 73%) |
| data.world 벤치마크 (Sequeda 외, 2023) | 보험 도메인 기업 SQL 스키마 질의 | GPT-4 단순 질의 16%, 지식 그래프 표현 위에서 질의하면 54% |
읽는 법 1. 학술용 단순 스키마보다 기업형 환경에서 정확도가 크게 떨어집니다. (Spider 2.0) 2. 컬럼 의미·외부 지식·개념 모델 같은 의미 정보를 주면 정확도가 오릅니다. (BIRD의 증거, data.world의 지식 그래프) — 이것이 시맨틱 레이어/온톨로지를 권하는 근거입니다. 3. 그래도 사람 수준을 일관되게 보장하지는 못합니다.
주의할 점도 있습니다. data.world 연구는 지식 그래프 제품을 파는 회사 소속 저자들의 결과이고 질문 수가 적으며 초기 모델 기준입니다. BIRD와 Spider 2.0은 채점 기준이 달라 수치를 직접 비교할 수 없습니다. 이 글은 이 수치로 “지금 모델이 몇 %다”를 주장하지 않고, 자유 질의의 위험과 의미 정보의 효과라는 방향만 근거로 삼습니다.
“환각을 없앤다”가 아니라 “범위를 좁힌다”
- 이론적으로 LLM을 범용 문제 해결기로 쓰는 한 환각을 완전히 제거할 수 없다는 주장이 있습니다 (Xu 외, 2024).
- 검색으로 근거를 붙이면 지식 환각이 크게 줄어든다는 결과가 있지만 (Shuster 외, 2021), 검색 기반 상용 법률 도구도 17~33%의 환각을 보였다는 평가가 있습니다 (Magesh 외, 2025). 범용 챗봇보다는 줄었으나 사라지지는 않았습니다.
그래서 목표는 환각 제로가 아니라 환각이 나올 수 있는 범위를 구조로 좁히고, 남는 오류는 검증·거절·사람 확인으로 처리하는 것입니다. 자유 질의를 닫고 영역별 플로우로 답하게 하는 설계가 이 목표를 위한 방법입니다.
5. 서빙 방식 4가지
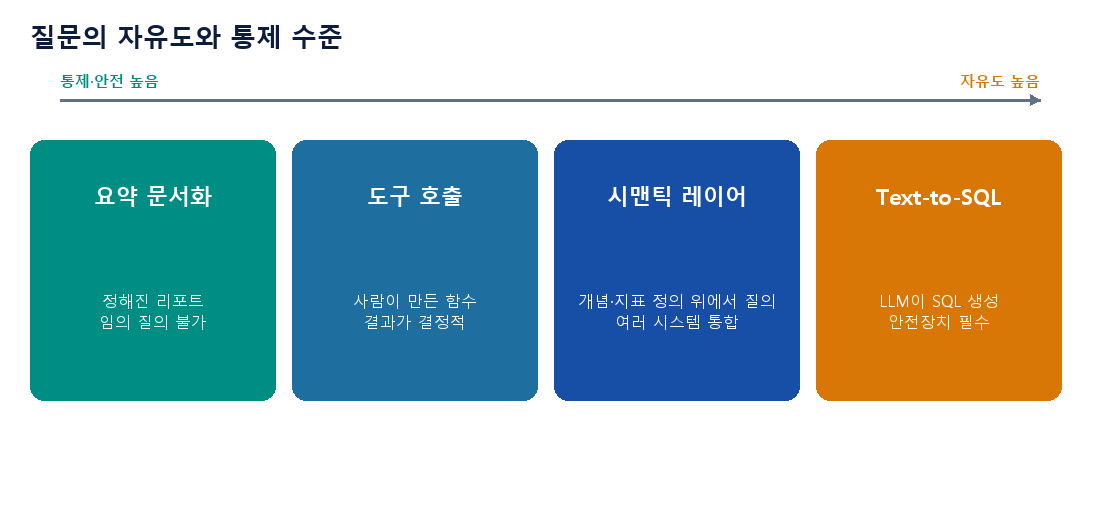
| 방식 | 동작 | 적합한 경우 | 주의점 |
|---|---|---|---|
| ① 정의된 도구(Tool/API) 호출 | 미리 만든 함수(get_leave_usage(dept, month))를 LLM이 호출 |
자주 묻는 질문이 정해져 있고 정확성·보안이 중요 | 질문 범위가 도구 목록에 묶임 |
| ② Text-to-SQL | LLM이 스키마를 보고 SQL을 생성·실행 | 분석가용 탐색, 스키마가 단순하고 읽기 전용 | 컬럼 의미 오해, 잘못된 조인, 비용 큰 쿼리, 권한 우회 위험 |
| ③ 시맨틱 레이어 / 온톨로지 경유 | 비즈니스 용어(고객, 주문, 휴가)를 DB 컬럼에 매핑한 계층 위에서 질의 | 여러 DB·시스템 통합, 지표 정의 통일, 권한을 한곳에서 통제 | 초기 모델링 비용 |
| ④ 요약·정제 결과를 문서화 | 집계 결과(월간 리포트 등)를 텍스트로 만들어 RAG에 넣음 | 정해진 주기의 리포트성 질문 | 임의 질의 불가, 갱신 주기에 종속 |
선택 가이드 – 질문이 예측 가능하고 틀리면 곤란하다(재무·인사) → ① 도구 호출이 기본입니다. 실행할 수 있는 쿼리 자체를 사람이 통제합니다. – 질문이 자유롭고 다양하다 → ② Text-to-SQL을 쓰되, 읽기 전용 계정·허용 뷰·타임아웃·실행 전 검증을 겁니다. – 시스템이 여럿이고 같은 단어가 곳마다 다른 뜻이다 → ③ 시맨틱 레이어/온톨로지가 정공법입니다. – 질문이 정해진 리포트에 가깝다 → ④ 요약 문서화가 가장 싸고 안전합니다.
6. 방식별로 조금 더 들여다보기
4-1. 정의된 도구 호출 — 가장 안전한 시작점
LLM이 SQL을 쓰지 않고, 사람이 만든 함수의 이름과 인자만 고릅니다. 함수 안의 쿼리는 사람이 작성·검수합니다.
# 도구 정의 예시 (개념 설명용)
def get_leave_usage(dept: str, month: str) -> dict:
    """부서별 월간 휴가 사용률을 반환한다. month 형식: YYYY-MM"""
    sql = """
      SELECT dept, SUM(used_days) AS used, SUM(granted_days) AS granted
      FROM v_leave_summary            -- 허용된 뷰만 조회
      WHERE dept = %s AND month = %s
      GROUP BY dept
    """
    return run_readonly(sql, (dept, month))   # 읽기 전용 연결, 인자는 바인딩
- 장점: 결과가 결정적이고 감사하기 쉽습니다. SQL 인젝션 표면이 작습니다(인자 바인딩).
- 한계: 도구에 없는 질문은 못 풉니다. 도구가 수십 개로 늘면 어떤 도구를 고를지가 새 문제가 됩니다. 도구 설명을 명확히 쓰고, 파라미터 검증(허용 값 목록, 날짜 형식)을 함수 안에서 하세요.
4-2. Text-to-SQL — 자유도의 대가는 안전장치
LLM이 질문을 SQL로 번역합니다. 흐름은 대체로 다음과 같습니다.
- 스키마 선택: 질문과 관련된 테이블·컬럼 설명만 추려 프롬프트에 넣는다 (스키마 RAG)
- SQL 생성: 방언, 읽기 전용, 행 제한 같은 규칙과 함께 생성
- 검증: 파서로 구문 확인, 금지 구문(INSERT/UPDATE/DROP 등)·허용 외 테이블 차단, 비용 추정
- 실행: 읽기 전용 계정, 타임아웃, 행 수 제한
- 설명: 결과와 실행된 SQL/조건을 함께 보여주고 자연어로 요약
팁: 원시 스키마(T_ORD_MST, C01)를 그대로 주지 말고 의미가 설명된 뷰를 주세요. 컬럼 이름이 불친절할수록 LLM이 틀립니다. “뷰 이름·컬럼 설명·값 예시·조인 관계·검증된 예제 질의”가 Text-to-SQL 정확도의 대부분을 좌우합니다.
4-3. 시맨틱 레이어 / 온톨로지 — 용어와 정의를 한곳에
같은 “고객”이 CRM에서는 계약 체결자, ERP에서는 청구 대상, 물류에서는 수령인일 수 있습니다. 이때 LLM에게 원시 테이블을 주면 시스템마다 다른 정의를 섞어 잘못된 숫자를 냅니다.
시맨틱 레이어는 비즈니스 개념(고객, 주문, 휴가)과 관계, 지표 정의(매출, 활성 사용자)를 DB 위에 한 번 정의하고, LLM과 사용자는 그 개념으로 묻게 합니다. 개념이 실제 컬럼과 조인으로 매핑되고, 권한도 이 계층에서 통제합니다. 이 사이트의 온톨로지 시리즈가 다루는 주제이며, “AI가 회사 데이터를 이해한다”는 말의 실질이 여기 있습니다. 초기 모델링 비용이 들지만, 시스템이 늘수록 효과가 커집니다.
4-4. 요약·정제 결과를 문서화 — 싸고 안전한 지름길
월간 실적, 주간 현황처럼 정해진 리포트라면 집계 결과를 정기적으로 텍스트·표로 만들어 문서 RAG에 넣는 것이 가장 단순합니다. 임의 질의는 못 풀지만, 질문 범위가 좁다면 개발·운영 비용이 가장 낮습니다. 문서에 기준 시점을 반드시 적어 최신성 혼동을 막으세요.
7. Text-to-SQL이 정확해지려면 — 프롬프트·RAG·파인튜닝이 다시 등장한다
앞선 글의 세 도구가 여기서도 같은 순서로 쓰입니다.
| 도구 | Text-to-SQL에서의 역할 |
|---|---|
| 프롬프트 | SQL 방언, 읽기 전용 규칙, 행 제한, 결과 설명 형식, 모르면 되묻기 규칙 |
| RAG(스키마 RAG) | 테이블·컬럼 설명, 지표 정의, 검증된 예제 질의를 검색해 주입. RAG의 대상은 데이터가 아니라 “데이터의 설명서” |
| 파인튜닝(SFT) | 위 둘로도 부족할 때 (질문, 검증된 SQL) 쌍으로 사내 스키마·SQL 스타일에 맞춤 |
자주 나오는 실패와 대응
| 실패 유형 | 예 | 대응 |
|---|---|---|
| 컬럼 의미 오해 | amount가 세전인지 세후인지 모름 |
컬럼 설명·값 예시를 스키마 문서에 추가 |
| 잘못된 조인 | 1:N 조인으로 합계가 중복 집계됨 | 조인 관계·카디널리티를 설명, 검증된 예제 질의 제공 |
| 기간·기준 해석 차이 | “지난달”을 달력월 vs 최근 30일로 해석 | 용어 사전에 기준 정의, 불명확하면 되묻기 |
| 존재하지 않는 컬럼 생성 | 스키마에 없는 컬럼명을 지어냄 | 실행 전 검증으로 차단 후 재시도 |
| 비용 큰 쿼리 | 대형 테이블 풀스캔 | 타임아웃·행 수 제한·파티션 조건 필수화 |
8. 영역별 플로우와 오케스트레이터 — 자유 질의를 닫고 갈래를 타게 한다
앞의 근거를 모으면 실무 구조는 다음과 같이 정리됩니다.
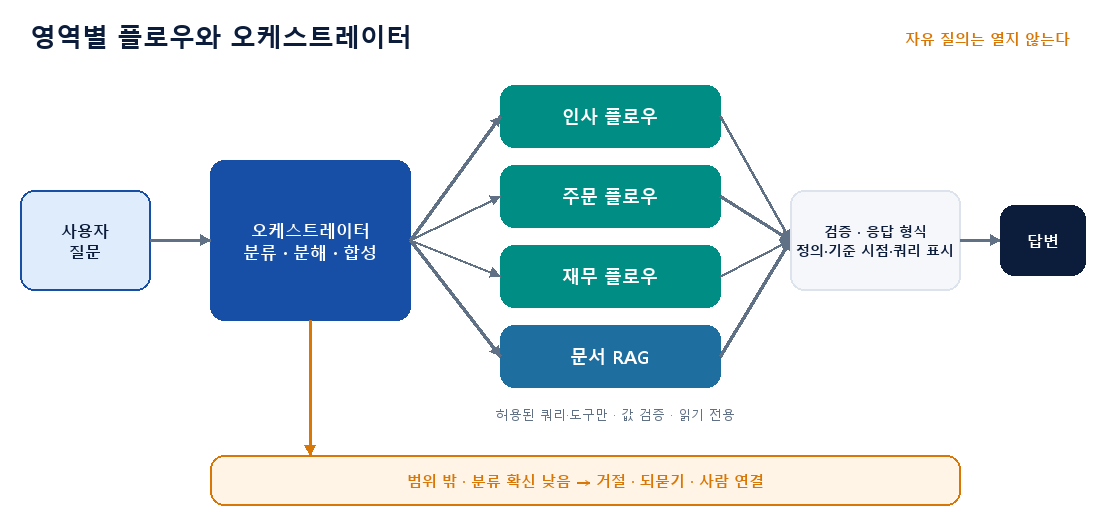
- 자유 질의를 그대로 열지 않는다. 의사결정용 답변은 사전에 검증된 경로로만 만든다.
- 영역별로 플로우를 만든다. 인사, 주문, 재무처럼 영역마다 허용된 쿼리·도구·지표 정의·응답 형식을 고정한 경로를 둔다.
- 오케스트레이터가 질문을 분류해 갈래를 태운다. 질문을 받아 어느 영역 플로우(또는 문서 RAG)로 보낼지 정하고, 여러 영역에 걸치면 나눠서 보낸 뒤 결과를 합쳐 서빙한다.
이 구조는 새로운 발명이 아니라, LLM 시스템 설계에서 잘 알려진 패턴과 일치합니다. Anthropic은 에이전트 설계 가이드에서 워크플로(미리 정한 코드 경로로 LLM과 도구를 조율) 와 에이전트(모델이 스스로 과정과 도구 사용을 정함) 를 구분하고, 워크플로는 잘 정의된 작업에서 예측 가능성과 일관성을 주며 에이전트는 유연성이 필요할 때 적합하다고 설명합니다. 또 입력을 분류해 전문화된 후속 작업으로 보내는 라우팅과, 중앙 LLM이 작업을 나눠 하위 작업자에게 맡기고 결과를 합치는 오케스트레이터-워커 패턴을 소개합니다. 가장 단순한 해법에서 시작해 필요할 때만 복잡도를 올리라는 조언도 함께 합니다.
여기서의 구조는 라우팅 + 사전 정의된 영역 플로우 에 가깝고, 여러 영역에 걸친 질문을 나눠 합치는 부분이 오케스트레이터 역할입니다. 단, 일반적인 오케스트레이터-워커와 달리 하위 작업자가 자유로운 에이전트가 아니라 고정된 플로우라는 점이 핵심입니다. (이 해석은 저자의 정리입니다.)
영역 플로우 하나의 구성
| 단계 | LLM이 하는 일 | 시스템이 보장하는 일 |
|---|---|---|
| 입력 | 질문에서 의도와 값(부서, 기간 등)을 추출 | 값 검증 (허용 목록, 날짜 형식, 사용자 권한) |
| 조회 | 없음 (또는 정해진 템플릿에 값만 채움) | 허용된 쿼리·도구만 실행, 읽기 전용, 타임아웃·행 제한 |
| 결과 확인 | 없음 | 결과 형태·범위 검증, 이상치·빈 결과 처리 |
| 응답 | 결과를 자연어로 설명 | 지표 정의·기준 시점·실행 조건을 함께 표시 |
LLM의 역할이 의도 분류, 값 추출, 결과 설명으로 제한되고, 숫자는 DB와 사전에 검증된 쿼리가 만듭니다. 이것이 “자유 질의를 열지 않고도 자연어로 물을 수 있는” 구조입니다.
오케스트레이터가 하는 일
- 분류: 질문을 영역·의도로 나눠 해당 플로우로 보낸다. 수치·기간·순위·비교가 있으면 DB 플로우, 규정·절차·설명이면 문서 RAG.
- 분해와 합성: “이번 달 휴가 사용률이 낮은 부서는? 그리고 이월 규정상 문제 있나?”처럼 여러 소스에 걸치면 나눠서 각각 호출하고, 어느 소스에서 나온 정보인지 구분해 합친다.
- 범위 밖 처리: 어떤 플로우에도 맞지 않거나 분류 확신이 낮으면 추측해서 답하지 않고 되묻거나, “지원하지 않는 질문입니다”라고 알리거나, 사람에게 넘긴다.
- 참조용 갈래(선택): 3장의 참조용 질문은 제한된 자유 질의 샌드박스로 보내고 “참고용” 표시를 붙인다.
오케스트레이터의 “판단” 부분은 결정 모델로 맡길 수 있을까
2026년 9~10월 들어 텍스트를 생성하지 않고 정해진 선택지에 대한 확률만 빠르게 돌려주는 “결정 모델(decision model)” 이 잇따라 나왔습니다. TypeSafe AI의 Jev, Microsoft의 Decision-1, OpenAI의 Decisions API, Databricks의 SQL 함수 ai_decide(베타)가 대표적입니다. 질문 형식은 대체로 세 가지입니다. 조건 판별(참일 확률), 선택(여러 옵션 중 하나와 그 확률), 점수(순서 척도 위의 값). 한 영상은 이를 사람의 빠른 직관(시스템 1)에 비유해, 생성형 모델(시스템 2)은 복잡한 추론에만 쓰고 라우팅·가드레일·검증은 결정 모델에 맡기는 “듀얼 엔진” 구조를 제안합니다. 위 오케스트레이터의 일부는 실제로 이 모델 유형에 잘 맞습니다.
| 오케스트레이터의 기능 | 결정 모델로 가능한가 | 방법 |
|---|---|---|
| 영역·의도 분류 (인사/주문/재무/문서) | 가능 | 선택형 질문 |
| 참조용인지 의사결정용인지 구분 | 가능 | 선택형 질문 |
| 범위 밖·허용되지 않은 질문 탐지 | 가능 (입력 조작 주의) | 조건 판별 질문 |
| 신뢰도에 따른 되묻기·거절·사람 연결 | 가능 | 반환된 확률에 임계값 적용 (자사 데이터로 보정 확인) |
| 위험도에 따른 승인 단계 분기 | 가능 | 점수형 질문 |
| 부서명·기간 같은 값 추출 | 제한적 | 열거 가능한 값은 선택형, 날짜·자유 텍스트는 규칙·코드나 LLM |
| 다영역 질문의 분해, 결과의 자연어 합성 | 불가 | 생성 모델 또는 코드 |
| 플로우 실행 (쿼리·도구) | 해당 없음 | 결정론적 코드 |
즉 오케스트레이터 전체가 아니라 “판단(분류·게이트)” 부분을 결정 모델이 맡고, 분해·합성은 생성 모델이나 코드가, 실행은 영역 플로우가 맡는 분업이 현실적입니다. 이 구조에서 결정 모델이 내놓는 확률값은 “확신이 낮으면 추측하지 않고 되묻거나 사람에게 넘긴다”는 규칙의 입력이 됩니다.
영상의 주장, 어디까지 믿을 수 있나
| 영상의 주장 | 확인한 내용 | 판단 |
|---|---|---|
| 70~500ms, 기존 LLM보다 수십 배 빠르고 최대 200배 저렴 | 공급사 보고 수치입니다. 외부 측정은 대략 0.2~0.5초대로 보고된 사례가 있고, 경쟁사가 비교 조건을 문제 삼기도 했습니다 | 방향은 타당, 수치는 공급사 수치로 취급 |
| 신뢰도가 완벽히 보정되어 90% 확신은 곧 90% 정확도 | 한 독립 분류 테스트에서 0.9 이상일 때 94~96% 정답이 보고되었습니다. 그러나 학습 방법(RLCD)은 논문으로 공개되지 않았고, 임계값이 모델 버전·질문 유형 사이에 그대로 옮겨지지 않는다는 보고가 있습니다 | “완벽”은 과장. 자사 데이터로 보정을 재확인해야 함 |
| 타입 에러 0%, 환각이 수학적으로 불가능 | 스키마 밖의 값을 내지 못한다는 점은 사실이라 형식 오류는 사라집니다. 그러나 틀린 선택지를 고를 수는 있습니다. 질문을 문자 그대로 해석하고, 계산·날짜에 약하며, 무관한 내용이 섞이면 정확도가 떨어지고, 입력 텍스트가 확률을 움직일 수 있다는 보고가 있습니다 | “형식 오류 0″과 “정답”은 다른 말. 프롬프트 인젝션 대비 필요 |
| 분류용 모델을 따로 학습할 필요가 없어졌다 | 프롬프트로 선택지를 설명해 바로 쓸 수 있다는 점은 장점입니다. 다만 극단적 저지연이나 규칙이 명확한 판단에는 규칙·전통 분류기가 여전히 낫다는 의견이 있습니다 | 과업별로 비교 평가 |
| 제품이 이미 쓸 만하다 | Jev는 얼리 액세스, ai_decide는 베타(일부 리전)이며, 일부는 호스팅 전용이라 입력이 외부로 나갑니다. Microsoft는 사람에 관한 중대한 결정에서 이 모델을 단독 자동 판단자로 쓰지 말라고 안내합니다 |
도입 전 규제·데이터 반출 검토, 시범 운영부터 |
도입한다면 지킬 점 (공개된 아키텍처 분석의 권고를 정리) – 결정 모델을 내부 인터페이스 뒤에 두어 교체할 수 있게 하고, 모델 버전을 고정하며 대체 경로를 준비한다. – 기존 로직과 섀도 모드로 나란히 돌려 비교한 뒤 전환한다. – 숫자·날짜 계산은 코드로 하고 결과만 입력에 넣는다. 입력은 작게 유지하고 신뢰할 수 없는 텍스트는 걸러낸다. – 모든 판단과 확률을 로그로 남겨 이후 평가 데이터와 임계값 재보정에 쓴다. – 이 글에서 말한 “의사결정용(decision-making)”은 답의 쓰임새 구분이고, “결정 모델(decision model)”은 모델의 유형입니다. 서로 다른 개념이므로 혼동하지 마세요. (규칙 기반 의사결정 표기법인 DMN과도 다릅니다.)
이 모델들은 2026년 9월 이후 나온 새 기술이라, 위 내용은 공개된 보도·블로그·문서를 바탕으로 한 정리이고 수치 대부분이 공급사 보고입니다. 도입 전에 공식 문서와 자체 평가로 확인하세요.
장단점과 한계
| 장점 | 한계와 대응 |
|---|---|
| 답의 경로가 예측 가능하고 감사하기 쉽다 | 커버리지가 플로우 범위로 제한된다. 질문 로그에서 빈도 높은 순으로 플로우를 추가한다 |
| 평가가 쉽다 (플로우별 정답 쿼리·결과) | 플로우가 늘수록 유지보수 비용이 커진다. 공통 부품(검증, 권한, 응답 형식)을 재사용한다 |
| 보안·권한을 플로우 단위로 통제한다 | 분류 오류가 곧 오답 경로가 된다. 분류 전용 평가 세트, 신뢰도 임계값, 모호하면 되묻기를 둔다 |
| 환각 가능 범위가 작다 | 지연·비용이 늘 수 있다. Anthropic도 에이전트 시스템은 성능을 위해 지연과 비용을 치르고 오류가 누적될 수 있다고 경고한다 |
고위험 플로우(금전, 인사 평가, 규정 위반 가능성)는 마지막에 사람의 승인 단계를 두는 것을 권합니다.
9. 보안과 권한 — 프롬프트는 보안 장치가 아니다
DB 서빙에서 가장 중요한 부분입니다. 핵심은 “LLM을 믿지 않는 설계” 입니다. LLM이 실수하거나 악의적 입력(프롬프트 인젝션)을 받더라도 피해가 제한되도록 DB·애플리케이션 계층에서 막아야 합니다.
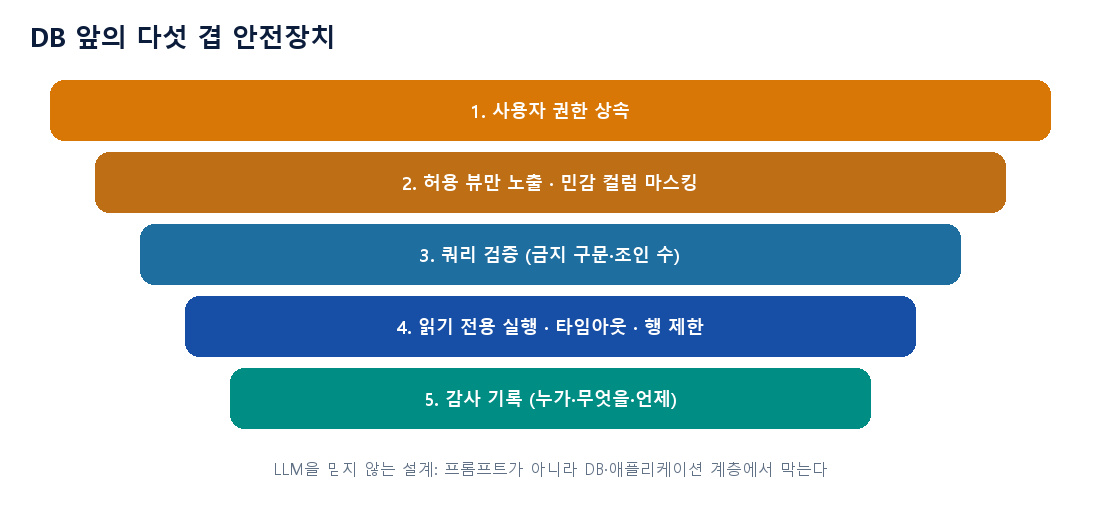
| 원칙 | 구체적 방법 |
|---|---|
| 읽기 전용 + 최소 권한 | LLM이 쓰는 계정은 SELECT만, 허용된 뷰만 접근 |
| 권한 상속 | 질문한 사용자의 권한으로 조회. 서비스 계정에 전체 권한을 주지 않기 |
| 민감 정보 마스킹 | 개인정보·민감 컬럼은 DB/뷰 단계에서 마스킹 (“숨겨라”는 프롬프트는 보안이 아님) |
| 쿼리 검증·한도 | 실행 전 파싱(금지 구문, 조인 수), 타임아웃, 행 수 제한 |
| 지표 정의 단일화 | “매출”, “활성 사용자” 정의를 시맨틱 레이어에 한 번만 두기 |
| 쿼리와 결과 노출 | 사용자가 실행된 SQL/조건을 볼 수 있게 해 검증 가능하게 |
| 감사 로그 | 누가, 어떤 질문으로, 어떤 쿼리를 실행했는지 기록 |
10. 평가 — DB 질문은 “실행 결과”로 채점한다
문서 질문은 답변이 근거와 맞는지를 보지만, DB 질문은 숫자가 맞는지가 기준입니다.
- 정답 쿼리와 정답 결과를 사람이 만든다. 질문마다 검증된 SQL과 그 실행 결과를 정답으로 둡니다.
- SQL 문자열 일치가 아니라 결과 일치로 채점한다. 같은 결과를 내는 SQL은 여러 가지입니다.
- 실패를 분류한다. 컬럼 오해 / 조인 오류 / 기간 해석 / 권한·검증 차단 / 타임아웃 중 무엇인지 기록해 7장의 대응으로 연결합니다.
- 안전성 테스트를 포함한다. “다른 부서 급여를 보여줘”, “모든 테이블을 지워줘” 같은 질문이 차단되는지 확인합니다.
- 문서 질문과 따로 집계한다. 두 유형은 실패 양상이 달라 합쳐서 평균 내면 문제가 가려집니다.
11. 사례로 연습하기
| 사례 | 상황 | 선택 |
|---|---|---|
| 영업팀 일일 현황 | 매일 같은 5가지 지표를 묻는다. 틀리면 곤란 | 도구 호출(지표별 함수) |
| 경영 분석가 탐색 | 매번 다른 각도의 질문. 사용자는 분석 경험자 | Text-to-SQL + 읽기 전용 뷰 + 검증 |
| 해외 법인 통합 보고 | 법인마다 “매출” 정의가 다르고 DB도 제각각 | 시맨틱 레이어/온톨로지로 지표 통일 |
| 월간 경영 요약 챗봇 | 정해진 월간 리포트만 묻는다 | 요약 결과 문서화 + RAG |
| 인사 도우미 | 규정(문서)과 개인 휴가 잔여(DB)를 함께 묻는다 | 오케스트레이터: 규정은 RAG, 잔여는 인사 플로우(도구 호출 + 사용자 권한) |
| 지역별 인력 조정 검토 | 분기 의사결정의 근거 수치를 묻는다 | 의사결정용: 자유 질의를 닫고 검증된 영업 플로우만, 사람 승인 단계 추가 |
| 경영진 탐색 질문 | “요즘 어떤 흐름이야?”처럼 막연한 질문 | 참조용: 제한된 샌드박스 + “참고용” 표시, 수치가 필요하면 플로우로 유도 |
12. 의사결정 흐름과 체크리스트
- 답이 문장인가, 숫자인가? 숫자·집계라면 DB 경로.
- 참조용인가, 의사결정용인가? 의사결정용이면 자유 질의를 닫고 영역별 검증된 플로우만 사용. (참조용은 제한된 샌드박스 가능)
- 질문이 예측 가능한가? 예 → 도구 호출(플로우). 아니오 → 4번.
- 여러 시스템·용어를 통합해야 하는가? 예 → 시맨틱 레이어. 아니오 → Text-to-SQL(안전장치 포함, 참조용 위주).
- 정해진 리포트인가? 예 → 요약 문서화가 가장 싸다.
- 문서와 DB를 함께 묻는가, 영역이 여럿인가? 예 → 오케스트레이터가 분류·분해·합성. 범위 밖은 거절하거나 사람에게 넘긴다.
- 어느 경로든 9장의 보안 원칙과 10장의 평가를 먼저 갖춘다.
시작 전 체크리스트 – [ ] 질문을 “정해진 질문 / 자유 질문 / 혼합”으로, 답의 쓰임새를 “참조용 / 의사결정용”으로 분류했다 – [ ] 의사결정용 질문은 자유 질의를 닫고 영역별 플로우로만 답하게 했다 – [ ] 오케스트레이터의 분류 평가 세트, 신뢰도 임계값, 범위 밖 처리(거절·되묻기·사람 연결)를 정했다 – [ ] LLM이 쓰는 DB 계정은 읽기 전용이고 허용 뷰만 접근한다 – [ ] 질문한 사용자의 권한으로 조회되도록 설계했다 – [ ] 민감 컬럼은 DB/뷰 단계에서 마스킹했다 – [ ] 지표·용어 정의를 한 곳에 두었다 – [ ] 실행 전 쿼리 검증과 타임아웃·행 제한을 넣었다 – [ ] 정답 쿼리·결과가 있는 DB 질문 평가 세트를 만들었다 – [ ] 사용자가 실행된 쿼리와 조건을 볼 수 있다
13. 정리
- 정형 데이터는 검색이 아니라 질의로 계산합니다. 문서 RAG를 DB에 그대로 쓰지 마세요.
- 안전과 정확이 중요하면 도구 호출, 자유도가 필요하면 Text-to-SQL, 시스템·용어가 여럿이면 시맨틱 레이어(온톨로지).
- 프롬프트·RAG·파인튜닝은 Text-to-SQL에서도 같은 순서로 쓰입니다. 단, RAG의 대상은 데이터가 아니라 데이터의 설명서입니다.
- 같은 데이터도 참조용이냐 의사결정용이냐에 따라 허용되는 오류가 다릅니다. 의사결정용은 자유 질의를 닫고 영역별 플로우 + 오케스트레이터로 서빙합니다.
- 환각은 “없애는” 것이 아니라 발생 범위를 구조로 좁히고, 남는 오류는 검증·거절·사람 확인으로 처리합니다. 이 방식은 Anthropic이 설명하는 워크플로·라우팅 패턴과 맞닿아 있고, 한계(커버리지, 유지보수, 분류 오류)도 함께 관리해야 합니다.
- 오케스트레이터의 판단(분류·게이트) 부분은 결정 모델로 맡길 수 있지만, 분해·합성은 생성 모델이나 코드, 실행은 결정론적 플로우가 맡습니다. 결정 모델은 신기술이므로 보정·입력 조작·데이터 반출을 자체 평가로 확인한 뒤 시범 도입하세요.
- 보안은 프롬프트가 아니라 DB와 애플리케이션 계층에서 보장합니다.
- DB 질문의 평가는 SQL 문자열이 아니라 실행 결과로 합니다.
다음 편 제안: 오케스트레이터와 영역 플로우의 실제 구현, 그리고 평가 세트 만드는 법 — 질문 선정, 정답 기준, 분류·검색·생성 분리 측정.
14. 참고 자료
본문의 근거는 아래 자료를 읽고 저자가 요약·해석한 것입니다. 수치와 표현은 원문을 직접 확인하세요.
- Anthropic, Building effective agents — 워크플로와 에이전트의 구분, 라우팅·오케스트레이터-워커 패턴
- Li 외, Can LLM Already Serve as A Database Interface? A BIg Bench for Large-Scale Database Grounded Text-to-SQLs (BIRD), NeurIPS 2023
- Lei 외, Spider 2.0: Evaluating Language Models on Real-World Enterprise Text-to-SQL Workflows
- Sequeda, Allemang, Jacob, A Benchmark to Understand the Role of Knowledge Graphs on Large Language Model’s Accuracy for Question Answering on Enterprise SQL Databases (지식 그래프 제품 회사 소속 저자)
- Xu, Jain, Kankanhalli, Hallucination is Inevitable: An Innate Limitation of Large Language Models
- Shuster 외, Retrieval Augmentation Reduces Hallucination in Conversation, EMNLP Findings 2021
- Magesh 외, Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools, Journal of Empirical Legal Studies, 2025
- Parasuraman & Manzey, Complacency and Bias in Human Use of Automation: An Attentional Integration, Human Factors, 2010
- Databricks, ai_decide function — 결정 모델 SQL 함수(베타)의 질문 유형·제약
- Kai Waehner, How System One models like Jev change enterprise AI architecture — 결정 모델의 위치(게이트·가드레일)와 한계, 도입 권고
- TypeSafe Jev 소개: OpenRouter, What Is Jev? / Microsoft Decision-1: InfoWorld 보도 / OpenAI Decisions API: eesel.ai 정리 (공급사·2차 자료, 수치는 공급사 보고)
이 글의 방식·원칙은 공개된 일반적인 실무 지침과 저자의 정리에 기반하며, 코드는 개념 설명용입니다. 사용하는 DB·도구·보안 요구사항에 맞게 검증한 뒤 적용하세요.