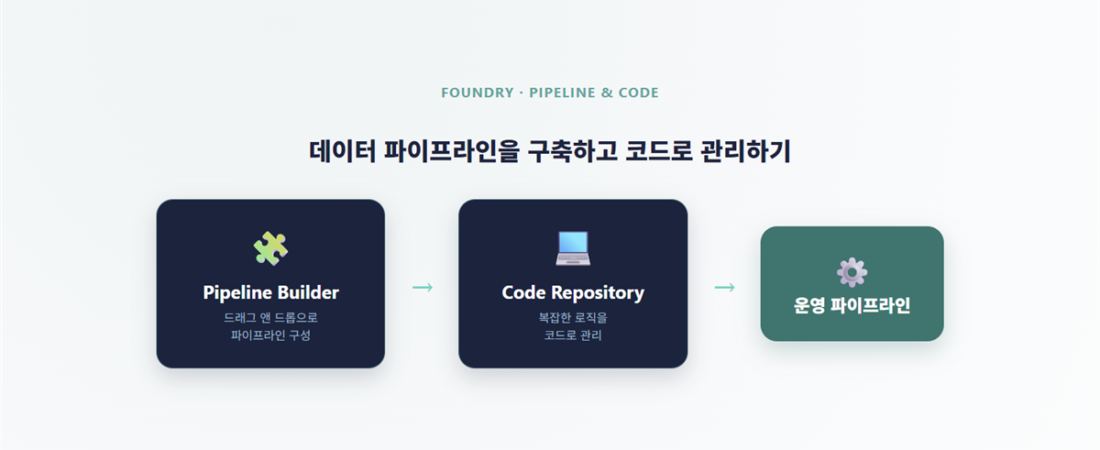
클릭 몇 번으로 시작했다가, 코드로 옮겨간 이야기
“일별 매출을 상품 카테고리별로 집계해줘.” 처음에는 간단해 보였습니다. Pipeline Builder를 열고, 주문 데이터셋을 연결하고, 필터와 조인, 집계 블록을 드래그해서 이어 붙이니 몇 분 만에 결과가 나왔습니다.
그런데 얼마 뒤 요구사항이 하나 붙었습니다. “블랙프라이데이 같은 프로모션 기간에는 할인 전 원가 기준으로도 따로 집계해줘. 프로모션 기간 목록은 계속 바뀌니까 매번 수동으로 못 넣어.” 이 조건 분기를 Pipeline Builder의 블록만으로 표현하려니 점점 복잡해졌습니다. 이 지점에서 Code Repository로 옮겨가게 됩니다.
Pipeline Builder — 드래그 앤 드롭으로 시작하기 좋은 이유
Pipeline Builder는 DAG(방향성 비순환 그래프) 구조로, 데이터가 한 방향으로만 흐르게 만들어줍니다. 순환이 없어서 흐름이 명확합니다.
- Source: 원천 데이터를 읽어옵니다 (주문 데이터셋)
- Transform: 정제·가공·병합을 합니다 (카테고리별 그룹핑, 필터링)
- Sink: 최종 결과를 새 Dataset으로 저장합니다 (일별 매출 집계 결과)
행 단위 변환(타입 변환, 문자열 조작)과 데이터셋 단위 변환(필터링, 조인, 집계)을 블록으로 이어 붙이면 됩니다. 가장 큰 장점은 팀원 누구나 이 화면만 보고도 데이터가 어떻게 흐르는지 바로 이해할 수 있다는 점입니다. 이 단계에서는 코드를 한 줄도 몰라도 됩니다.
Code Repository — “프로모션 기간 예외 처리”가 필요해진 순간
프로모션 기간이 계속 바뀌고, 그 기간에만 다른 집계 로직을 적용해야 한다면, 이건 GUI 블록으로 표현하기 번거로운 조건 로직입니다. 여기서부터는 Code Repository로 옮깁니다.
Code Repository의 철학은 “Everything as Code”입니다. 로직을 코드로 정의하면 이런 이점이 생깁니다.
- 변경 이력 추적: Git 커밋으로 “프로모션 기간 로직을 언제, 누가, 왜 바꿨는지”가 그대로 남습니다
- 재사용: 프로모션 기간 판별 함수를 만들어두면, 다른 파이프라인에서도 그대로 가져다 씁니다
- 코드 리뷰: Pull Request로 로직을 병합하기 전에 동료가 검토합니다
- 롤백: 새 로직에 문제가 있으면 이전 커밋으로 즉시 되돌릴 수 있습니다
Python, SQL, Java 등을 지원하므로, 프로모션 기간 목록을 별도 테이블로 관리하고 그 테이블을 참조해서 조건 분기하는 로직을 코드로 짤 수 있습니다.
실무에서는 이렇게 오간다
- 간단한 집계는 Pipeline Builder로 빠르게 구성합니다.
- 조건이 복잡해지는 부분만 골라서 Code Repository로 분리합니다.
- Transform 함수로 입력 Dataset과 출력 Dataset을 명확히 정의합니다.
- 빌드를 실행하고, Pull Request를 올려 동료의 코드 리뷰를 받습니다.
- 병합 후 프로덕션에 반영하되, 같은 입력에 같은 결과가 나오는 멱등성을 유지합니다.
일 매출 집계 사례라면, “카테고리별 단순 합산”은 Pipeline Builder에 남겨두고, “프로모션 기간 판별과 원가 기준 재계산”만 Code Repository의 함수로 분리하는 식입니다. 전체를 다 코드로 옮길 필요는 없습니다.
자주 하는 실수 5가지
GUI로 충분한 걸 굳이 코드로 짠다. 단순 필터나 조인까지 코드로 옮기면, 팀원들이 파이프라인 흐름을 한눈에 파악하기 어려워집니다.
하나의 Transform에 모든 로직을 몰아넣는다. 프로모션 판별, 원가 계산, 카테고리 매핑을 전부 한 함수에 넣으면, 나중에 프로모션 로직만 수정하려 해도 전체를 다시 검토해야 합니다.
Pull Request 절차를 생략한다. 급하다고 바로 병합하면, 반올림 로직 하나 잘못돼도 아무도 못 잡아냅니다.
원천 데이터 스키마 변화에 대비하지 않는다. 주문 데이터셋에 컬럼이 하나 추가되거나 이름이 바뀌면, 이를 감지하지 못한 파이프라인이 조용히 잘못된 결과를 내보낼 수 있습니다.
멱등성을 보장하지 않는다. 같은 날짜의 데이터로 파이프라인을 두 번 실행했을 때 결과가 달라진다면, 이건 나중에 재처리할 때 큰 혼란을 일으킵니다.
관련 개념
파이프라인의 최종 결과물은 Dataset이 되고, 이 Dataset은 Ontology Manager에서 Object Type으로 매핑됩니다. 그리고 이 데이터가 어디서 와서 어떻게 변환됐는지는 Data Lineage로 추적할 수 있습니다.
정리하면
Pipeline Builder와 Code Repository는 경쟁 관계가 아니라 역할 분담 관계입니다. 단순한 흐름은 눈으로 보고 바로 이해할 수 있는 GUI로, 조건이 복잡해지고 재사용과 리뷰가 필요한 부분은 코드로. 일 매출 집계 사례처럼, 처음엔 GUI로 시작했다가 필요한 부분만 코드로 옮기는 흐름이 실무에서 가장 자연스럽습니다.
자주 묻는 질문
Q. 처음부터 Code Repository로 시작하는 게 낫지 않나요? 간단한 파이프라인이라면 오히려 Pipeline Builder가 더 빠르고, 팀원 전체가 흐름을 이해하기 쉽습니다. 복잡도가 실제로 GUI의 한계에 부딪힐 때 옮기는 게 효율적입니다.
Q. 두 도구를 한 파이프라인 안에서 섞어 쓸 수 있나요? 네. Pipeline Builder의 특정 단계에서 Code Repository의 Transform 함수를 호출하는 식으로 혼합해서 쓰는 게 일반적입니다.