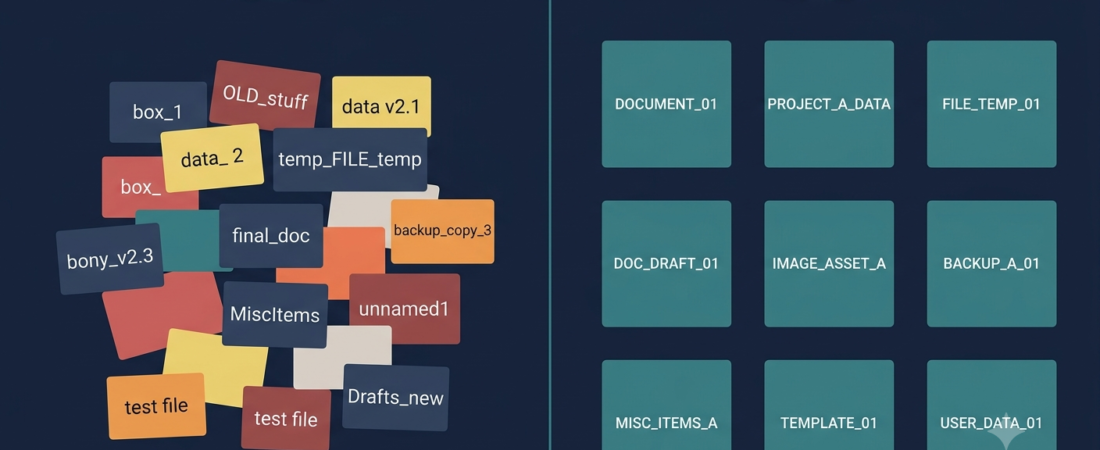
같은 고객을 가리키는 이름이 세 개다
온톨로지 객체가 150개를 넘어가던 어느 시점, 이런 일이 벌어졌다고 가정해보겠습니다. 영업팀이 만든 Customer Object Type이 있는데, 재무팀은 몰라서 Client라는 이름으로 똑같은 개념을 또 만들었습니다. 고객 지원팀은 한술 더 떠서 고객사라는 국문 이름으로 세 번째 버전을 만들었습니다. 세 팀 모두 “우리 고객 정보”를 다루고 있다고 생각하지만, 실제로는 서로 다른 온톨로지 객체 세 개가 따로 존재하는 상황입니다. 매출 대시보드를 만들 때 어떤 걸 기준으로 삼아야 할지, 아무도 자신 있게 답하지 못합니다.
이런 일이 왜 일어나는지, 그리고 어떻게 막을 수 있는지 정리합니다.
SAP와 온톨로지의 결정적 차이 — 코드가 없다
SAP 같은 기존 시스템에서는 ID(코드)와 설명(Description)이 분리되어 있습니다. 자재코드 M-10023과 그 설명 “스테인리스 볼트 M10″은 서로 독립적으로 관리되고, 코드 체계 자체가 시스템에서 강제됩니다. 담당자가 마음대로 자재코드 형식을 바꿀 수 없습니다.
Palantir 온톨로지는 다릅니다. 이름(Name) 하나만 존재합니다. 강제되는 코드 체계가 없기 때문에 네이밍이 전적으로 자유롭습니다. 이 자유로움이 초기에는 장점입니다. 담당자가 바로 이해할 수 있는 이름을 즉시 붙일 수 있으니까요. 하지만 이 자유로움이 바로 나중에 문제가 되는 지점이기도 합니다.
왜 시간이 지나면 무너지는가
초기 단계에는 문제가 없습니다. 팀 규모가 작고 온톨로지 객체 수도 몇 개 안 되니, 한두 사람이 전체를 파악하고 일관성을 유지할 수 있습니다.
규모가 커지면 세 가지 문제가 동시에 나타납니다.
- 동일 개념의 중복 생성: 앞서 예로 든 Customer / Client / 고객사처럼, 같은 개념을 팀마다 다른 이름으로 만듭니다.
- 언어 혼용: 어떤 Object Type은 영문으로, 어떤 건 국문으로, 어떤 건 영문·국문이 섞여 있습니다. 검색도 안 되고 일관성도 없습니다.
- Property 명명 기준 불일치: 어떤 팀은 원본 DB 컬럼명(
EKKO_MATNR)을 그대로 쓰고, 어떤 팀은 업무 용어(자재번호)로 바꿔서 씁니다.
더 큰 문제는 사후 수정 비용입니다. 온톨로지 객체 하나의 이름을 바꾸려면, 그 객체를 참조하는 모든 Workshop 화면, AIP 프롬프트, Link Type을 전부 다시 손봐야 합니다. 앞서 예로 든 세 개의 고객 객체를 나중에 하나로 통합하려면, 그동안 세 팀이 각자 만들어둔 화면과 워크플로우를 전부 재작업해야 하는 상황이 벌어집니다.
표준화 전략 4가지
① 영문 우선, 국문은 보조로
Object Type과 Property 이름은 영문으로 정의하고, 국문 설명은 Description 필드에 따로 기재합니다. Customer라는 이름은 하나로 고정하고, Description에 “고객사, 거래처”라고 병기하는 식입니다. 이렇게 하면 검색과 참조가 항상 하나의 이름으로 수렴됩니다.
② 표기 규칙을 문서로 남긴다
PascalCase(PurchaseOrder)인지 camelCase(purchaseOrder)인지 통일하고, 약어 사용 기준(예: “Purchase Order는 항상 PO로 줄이지 않는다”)과 복수형 처리 방식(Customers인지 Customer인지)을 문서로 명시합니다. 문서가 없으면 “저번엔 이렇게 했던 것 같은데”라는 기억에 의존하게 되고, 팀이 늘어날수록 이 기억은 어긋납니다.
③ 원본 DB 컬럼명이 아니라 업무 용어로
EKKO_MATNR 같은 원본 컬럼명을 온톨로지 Property 이름으로 그대로 쓰지 않습니다. 실제 업무에서 부르는 이름, 즉 “자재번호”에 대응하는 영문 이름(MaterialNumber)을 씁니다. 온톨로지의 목적이 애초에 “물리적 데이터 구조”가 아니라 “비즈니스 의미”를 담는 것이기 때문입니다.
④ 새로 만들기 전에 검색을 의무화한다
Object Type이나 Property를 새로 만들기 전에, 비슷한 개념이 이미 있는지 검색하는 절차를 의무화합니다. 이 절차 하나만 지켜도 Customer/Client 같은 중복 생성 대부분을 막을 수 있습니다.
Before / After로 보면
| 항목 | 표준화 이전 | 표준화 이후 |
|---|---|---|
| 고객 개념 | Customer / Client / 고객사 (3개 중복) | Customer 하나로 통합, 국문은 Description에 병기 |
| Property 명명 | EKKO_MATNR 그대로 사용 |
MaterialNumber로 업무 용어화 |
| 신규 생성 절차 | 팀별로 알아서 생성 | 생성 전 기존 객체 검색 의무화 |
| 표기 규칙 | 팀마다 제각각 | PascalCase로 통일, 문서화 |
실무 교훈: 임계점은 100~200개
경험적으로, 온톨로지 객체가 100~200개 규모에 도달하는 시점부터 이런 문제가 표면으로 드러나기 시작합니다. 그 이전까지는 “이 정도는 기억으로 관리되겠지”라는 생각이 통하지만, 그 이후부터는 통하지 않습니다.
가장 좋은 시점은 처음 설계할 때, 즉 객체 수가 아직 한 자릿수일 때 표준을 세우는 것입니다. 표준을 나중에 세우면, 이미 만들어진 객체들을 표준에 맞춰 재작업하는 비용이 처음부터 표준을 세웠을 때보다 수 배 더 듭니다.
정리하면
온톨로지의 자유로운 네이밍은 초기에는 속도를 주지만, 규모가 커지면 그 자유로움이 그대로 부채가 됩니다. 영문 우선, 표기 규칙 문서화, 업무 용어 기반 네이밍, 생성 전 검색 의무화. 이 네 가지를 객체 수가 적을 때 미리 세워두는 것이, 나중에 세 개로 쪼개진 고객 객체를 하나로 합치는 것보다 훨씬 쉽습니다.
자주 묻는 질문
Q. 이미 네이밍이 엉망이 된 온톨로지는 어떻게 정리해야 하나요? 한 번에 전부 바꾸려 하지 말고, 가장 많이 참조되는 핵심 객체(예: 고객, 주문)부터 먼저 표준화하세요. 그 객체를 참조하는 Workshop 화면과 Link Type을 함께 점검하면서 순차적으로 넓혀가는 방식이 안전합니다.
Q. 소규모 팀에서도 이런 표준이 꼭 필요한가요? 지금 당장은 필요 없어 보여도, 온톨로지 객체가 늘어나는 속도는 생각보다 빠릅니다. 표준 문서 자체는 A4 한 장 분량이면 충분하니, 객체가 열 개 남짓일 때 미리 만들어두는 걸 권합니다.
Q. 영문 이름이 어색하거나 직관적이지 않으면 어떻게 하나요? Description 필드에 국문 설명과 함께 사용 예시, 유사 개념과의 차이점을 적어두면 됩니다. 이름 자체보다 “이 이름이 무엇을 가리키는지 누구나 검색해서 확인할 수 있는가”가 더 중요합니다.